Fondamentaux du cloud avec GCP : modèles de service et responsabilités
Le CM1 a posé les fondements de l’ingénierie des données : cycle de vie (génération, ingestion, stockage, transformation, mise à disposition), architectures de stockage (data lake, data warehouse, lakehouse), pipelines ETL et ELT, bases relationnelles et NoSQL, et modélisation. Ces notions ne changent pas quand on passe au cloud.
Le CM2 les situe sur Google Cloud Platform. Deux questions guident ce chapitre. Qu’est-ce qui change au passage au cloud : facturation, élasticité, localisation des données ? Et quelles responsabilités restent à l’équipe une fois une partie de l’exploitation déléguée au fournisseur ?
Parmi les services data de GCP, ce cours s’intéresse ensuite à BigQuery, l’entrepôt analytique serverless : SQL à grande échelle, et maîtrise du coût des requêtes.
Objectifs du chapitre
À la fin de ce chapitre, vous saurez :
- expliquer le cloud computing, son passage du CAPEX à l’OPEX et ses limites économiques ;
- distinguer les modèles IaaS, PaaS et SaaS à partir du partage des responsabilités ;
- différencier un service managé d’un service serverless et expliquer leur mode de facturation ;
- analyser les enjeux de région, de résilience et de souveraineté des données ;
- choisir un service data GCP adapté et appliquer le principe du moindre privilège avec IAM.
Qu’est-ce que le cloud computing ?
Le cloud computing donne accès, à travers le réseau, à un ensemble de ressources informatiques (calcul, stockage, réseau) configurables à la demande. Selon la définition de référence du NIST, ces ressources sont mutualisées entre plusieurs clients, leur usage est mesuré pour la facturation et leur capacité peut être ajustée en continu.
L’une de ces caractéristiques essentielles est l’élasticité : la capacité d’adapter dynamiquement la puissance allouée à la charge réelle, qu’il s’agisse d’une action manuelle ou d’un mécanisme automatisé (autoscaling). Concrètement, une application dimensionnée pour une centaine d’utilisateurs quotidiens peut ainsi absorber un pic soudain de 10 000 connexions lors d’un événement, sans nécessiter l’achat ni la configuration préalable de nouveaux serveurs physiques.
Du CAPEX à l’OPEX
Avant le cloud, l’entreprise achetait ses serveurs et prévoyait ses besoins pour plusieurs années : c’est le CAPEX, une dépense d’investissement. En cas de pic d’activité, les machines pouvaient être insuffisantes ou, en dehors de ces pics, une partie de leur capacité pouvait rester peu utilisée.
Avec le cloud, les dépenses deviennent davantage des OPEX, des dépenses d’exploitation : l’entreprise paie des services au fil de leur consommation, par exemple le calcul, le stockage ou le trafic réseau. Le montant varie donc plus facilement avec l’activité, mais il ne devient pas totalement variable : certaines ressources sont facturées tant qu’elles sont provisionnées, et des engagements de capacité peuvent créer un coût régulier.
Où partent vos données ? Régions, zones et résilience
Une ressource cloud est rattachée à une région géographique précise (par exemple europe-west9 à Paris). Une région comprend plusieurs zones, isolées les unes des autres pour limiter l’impact d’une panne locale.
Cette organisation permet plusieurs niveaux de résilience technique :
- Répartir une base ou un service sur plusieurs zones (déploiement multi-zones) protège l’application de la défaillance d’un bâtiment ou d’une panne locale.
- Répartir son architecture sur plusieurs régions (multi-régions) réduit l’impact d’une panne affectant une région entière, mais introduit une latence inter-régions et des coûts additionnels de transferts de données.
De la localisation physique à la souveraineté juridique
Le choix d’une région ne se résume pas à un calcul de latence ou de prix. Le lieu de stockage ne suffit pas, à lui seul, à déterminer le cadre juridique applicable.
- Résidence des données et RGPD : choisir une région européenne permet de contrôler le lieu principal de stockage. Cela ne garantit pas que tous les traitements restent dans l’Union européenne et ne suffit pas à assurer la conformité au RGPD. Il faut aussi vérifier les options du service, les sous-traitants et les éventuels transferts hors de l’Espace économique européen.
- Nationalité du fournisseur et lois extraterritoriales : un fournisseur peut être soumis au droit de son pays d’origine. Dans certaines conditions, une autorité américaine peut demander des données placées sous le contrôle d’une entreprise américaine, même si elles sont stockées en Europe.
- Qualification SecNumCloud : cette qualification de l’ANSSI atteste un niveau élevé d’exigences techniques, opérationnelles et juridiques. Elle constitue un critère de choix pour les systèmes sensibles, sans remplacer l’analyse de risques.
Pour approfondir : sécurité des traitements cloud selon la CNIL et qualification SecNumCloud de l’ANSSI.
Panorama des fournisseurs cloud
Pour situer GCP, ce cours compare deux ensembles : les hyperscalers mondiaux et des fournisseurs européens davantage positionnés sur la localisation et la souveraineté. Cette présentation n’est pas exhaustive.
Les hyperscalers mondiaux (catalogue étendu et présence globale)
Trois géants américains concentrent l’essentiel du marché mondial grâce à la profondeur de leurs services managés de calcul et de données (BigQuery, Redshift, Synapse) :
| Fournisseur | Parts de marché (T2 2025) | Atouts clés |
|---|---|---|
| AWS (Amazon Web Services) | ~30 % | Précurseur, catalogue de services le plus large |
| Microsoft Azure | ~20 % | Forte intégration avec l’écosystème d’entreprise et Windows |
| Google Cloud (GCP) | ~13 % | Référence historique sur l’analytique data, BigQuery et l’IA |
Source : Synergy Research Group, 2025 (les trois acteurs représentent 63 % des dépenses d’infrastructure mondiales).
Les acteurs européens et souverains (indépendance et conformité ciblée)
Pour répondre aux besoins de localisation, de maîtrise juridique et de réduction de la dépendance technologique, plusieurs fournisseurs européens proposent des positionnements distincts :
| Fournisseur | Origine | Spécificités et positionnement |
|---|---|---|
| OVHcloud | France | Premier acteur européen, cloud public et privé, offres en cours ou certifiées SecNumCloud |
| 3DS Outscale | France (Dassault Systèmes) | Acteur pionnier sur la qualification SecNumCloud pour les secteurs critiques et sensibles |
| Scaleway | France (Groupe Iliad) | Écosystème complet orienté développeurs, intégrations conteneurs et IA |
| Clever Cloud | France | PaaS européen automatisé, axé sur l’expérience de déploiement |
Le choix dépend du besoin : profondeur du catalogue, localisation, exigences réglementaires et dépendance au fournisseur. Ce cours utilise GCP comme plateforme de référence.
Les modèles de service : IaaS, PaaS et SaaS
Le modèle de service précise la part de la pile technique gérée par le fournisseur. Avec l’IaaS, le client gère encore le système et les applications ; le PaaS ajoute une plateforme d’exécution ; le SaaS fournit directement l’application.
La pile de responsabilités
Tout système informatique repose sur une même pile de composants :
- en bas : le réseau, le stockage, les serveurs physiques, la virtualisation ;
- au milieu : le système d’exploitation, le middleware, le runtime ;
- en haut : les données et les applications.
La pile permet de voir les couches prises en charge par le fournisseur et celles qui restent sous la responsabilité du client.
De l’IaaS au SaaS, la part gérée par le fournisseur augmente. Le client conserve moins de contrôle technique, mais assume aussi moins de tâches d’exploitation.
IaaS - Infrastructure as a Service
Le fournisseur gère uniquement les couches basses. Tout le reste vous appartient : système d’exploitation, Python, Spark, sécurité applicative.
Analogie. Un appartement vide. Les murs et l’électricité sont là ; vous apportez les meubles et l’organisation.
Exemple GCP : Compute Engine, une machine virtuelle avec accès root complet. Vous choisissez le processeur, la mémoire, l’image disque, et vous appliquez vous-même les correctifs de sécurité. Profils concernés : architecte cloud, ingénieur DevOps.
PaaS - Platform as a Service
Le fournisseur gère l’infrastructure et la plateforme. Vous vous concentrez sur le code et les données.
Analogie. Un appartement meublé. La cuisine est prête ; vous apportez vos recettes et vos ingrédients.
Exemple GCP : Vertex AI Workbench, un notebook Jupyter dans le navigateur, Python préinstallé, connecté à BigQuery. Vous n’installez ni le système ni les pilotes, mais vous restez maître de votre code et de vos dépendances. Profils concernés : data engineer, data scientist.
SaaS - Software as a Service
Le fournisseur gère tout, jusqu’à l’application elle-même. Vous utilisez un outil fonctionnel directement, sans rien installer et sans écrire de code de déploiement.
Analogie. Une chambre d’hôtel. Le lit est fait ; vous arrivez et utilisez l’espace.
Exemple GCP : Looker Studio, où l’on connecte une source, compose un tableau de bord et le partage. Vous ne gérez que vos données, vos paramètres et vos accès. Profils concernés : data analyst, utilisateurs métier.
Où se situe BigQuery ?
Dans ce cours, nous rapprochons BigQuery du modèle PaaS : l’équipe conçoit les tables et les requêtes, tandis que Google exploite l’infrastructure. Les étiquettes IaaS, PaaS et SaaS sont utiles, mais le choix dépend surtout des responsabilités concrètes : maintenance, sécurité, configuration et exploitation. Son caractère serverless décrit un autre aspect : la façon dont le fournisseur alloue les ressources d’exécution.
Les services managés et serverless
Un service managé délègue au fournisseur des opérations courantes, selon le contrat du service : maintenance, correctifs, sauvegardes ou reprise après une panne. Ce terme ne définit pas un mode unique de facturation. Une instance Cloud SQL maintenue active conserve un coût de capacité provisionnée ; Cloud Storage facture notamment un volume d’objets conservés et des opérations.
Analogie. Un bureau loué dans un immeuble géré. Votre équipe garde son espace, pendant que le gestionnaire entretient le bâtiment et intervient en cas de panne. C’est le principe d’un service managé.
Avec un service serverless, le fournisseur alloue les ressources nécessaires à l’exécution sans que l’équipe administre les machines sous-jacentes. L’équipe peut encore configurer de la mémoire, du CPU, de la concurrence et des limites. Les serveurs existent ; leur exploitation est déléguée. Un service peut donc être à la fois managé et serverless.
Analogie. Une salle de réunion réservée seulement pour la durée d’un rendez-vous. Elle est attribuée et préparée à la demande, puis libérée après la réunion. C’est le principe du serverless.
Les contraintes d’exécution dépendent du service. Pour des fonctions ou des conteneurs, comme ceux de Cloud Run, il faut notamment examiner :
- Démarrage à froid (cold start). Le démarrage d’une nouvelle instance peut ajouter de la latence ; une instance déjà active peut être réutilisée.
- Durée et mémoire. Les limites et leurs réglages dépendent du service et du type de traitement : requête HTTP, tâche ou job SQL.
- État local. Des données en mémoire ou des fichiers temporaires peuvent subsister dans une instance réutilisée. Leur conservation n’est pas garantie lors d’un redémarrage ou d’un changement d’instance : l’état durable doit être placé dans un stockage adapté.
Ces contraintes ne constituent pas une définition universelle du serverless. Pour BigQuery, on examine notamment les quotas, la capacité en slots et les limites des jobs. Voir le contrat d’exécution Cloud Run et les quotas et limites BigQuery.
Choisir un service data sur GCP
Le panorama suivant regroupe les principaux services data de GCP par fonction : ingestion, traitement, orchestration, stockage, bases de données, gouvernance, BI et apprentissage automatique. Il permet d’identifier une famille de services avant de préciser le besoin.
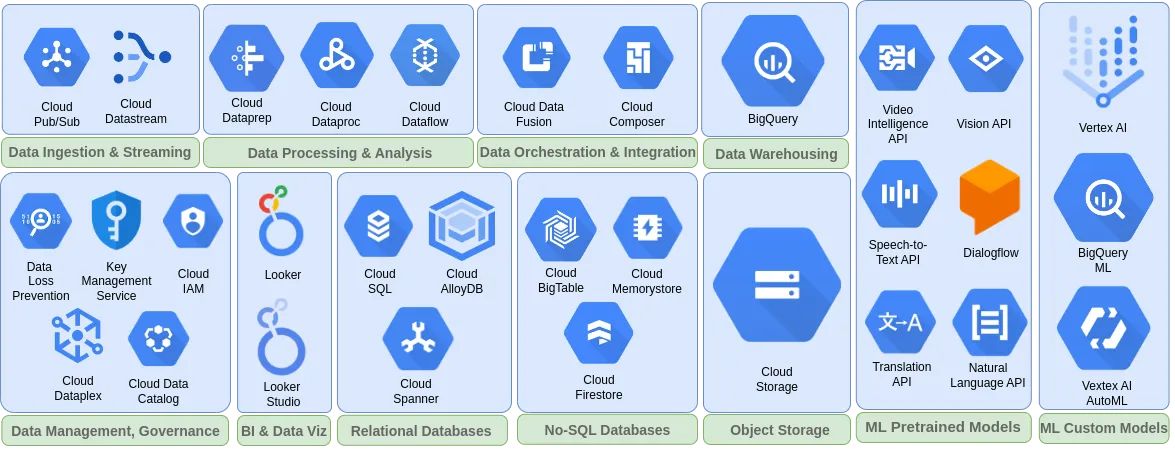
Source : Carmel Wenga, Master Data Engineering on GCP: Essential Tools & Services, 2024. Le visuel reflète les noms utilisés à sa publication. Data Catalog est désormais remplacé par Knowledge Catalog.
À partir de ce panorama, la grille suivante oriente le choix selon trois besoins : stocker, traiter ou exploiter les données. Elle fournit un point de départ. Le choix doit ensuite être vérifié selon le volume, la latence et les compétences de l’équipe.
IAM sur GCP : contrôler les accès
IAM, Identity and Access Management, définit qui peut agir sur une ressource Google Cloud. Une autorisation associe un principal (utilisateur, groupe ou compte de service), un rôle et une ressource. Le moindre privilège consiste à n’accorder que les droits nécessaires, sur le périmètre le plus restreint possible.
| Élément | Rôle | Exemple |
|---|---|---|
| Principal | Identité qui demande un accès | Un étudiant ou un compte de service |
| Rôle | Ensemble d’autorisations | roles/bigquery.dataViewer |
| Ressource | Élément protégé | Un dataset BigQuery ou un bucket |
| Portée | Niveau d’application du rôle | Organisation, projet, dataset ou bucket |
Idée clé. Un compte de service représente une application, pas une personne. Créer un compte distinct pour chaque application ou composant limite l’impact d’une erreur ou d’une compromission.
- Éviter les rôles de base, comme Éditeur, trop larges pour un environnement de production.
- Préférer les rôles prédéfinis, adaptés à un service précis.
- Attribuer les droits au niveau le plus fin possible : dataset plutôt que projet, par exemple.
- Utiliser un compte de service distinct pour chaque application ou composant.
- Réviser régulièrement les droits et supprimer les comptes ou accès inutilisés.
IAM rend les droits explicites et auditables. Le fournisseur protège l’infrastructure cloud ; l’équipe reste responsable des identités, des rôles et des données auxquelles ils donnent accès. Voir la documentation IAM de Google Cloud, les bonnes pratiques IAM et les recommandations de la CNIL sur les habilitations.
Les limites du cloud
L’élasticité ajuste la capacité à la charge. Le contrôle des données, le lien au fournisseur et le coût sur plusieurs années restent à examiner.
Souveraineté et gouvernance
La souveraineté (résidence des données, droit applicable, SecNumCloud) est traitée plus haut. La gouvernance en est le versant opérationnel : qui accède aux données, combien de temps elles sont conservées, et comment on le vérifie.
- Une région européenne fixe un lieu de stockage. Elle ne tient pas lieu de règle d’accès.
- IAM, les journaux d’audit et la durée de conservation rendent cette règle vérifiable.
- Sans gouvernance, la localisation reste un réglage technique.
Dépendance au fournisseur
Le fournisseur tient la roadmap : les fonctions livrées, les services retirés et les tarifs. Quitter cette roadmap a un coût.
- Les API propriétaires sont à réécrire chez un autre fournisseur.
- Les frais de sortie des données (egress) s’ajoutent au temps de migration.
- Des exports dans des formats ouverts réduisent cette dépendance.
Charge stable et FinOps
Sur une charge élevée et stable, des machines achetées peuvent revenir moins cher : le CAPEX s’amortit, alors qu’une capacité cloud est facturée chaque mois. Le FinOps mesure cette dépense et la compare aux alternatives.
- Le cloud reste adapté à une charge irrégulière ou difficile à prévoir.
- Une machine amortie laisse l’électricité, le renouvellement du matériel et l’équipe qui l’exploite.
- Une alerte de budget signale un dépassement. Un plafond configuré est ce qui peut interrompre la dépense.
- Cloud computing = ressources de calcul, de stockage et de réseau accessibles à la demande et ajustables selon l’usage.
- CAPEX, OPEX et FinOps = le cloud déplace la dépense vers l’exploitation. Sur une charge stable, un investissement amorti peut revenir moins cher. Le FinOps sert à mesurer cette dépense.
- Région et zone = la région fixe la localisation géographique ; les zones permettent de répartir les ressources pour améliorer la résilience.
- Souveraineté = la localisation des données, la nationalité du fournisseur et le cadre juridique doivent être examinés ensemble.
- IaaS, PaaS et SaaS = trois niveaux de partage des responsabilités entre le client et le fournisseur.
- Managé et serverless = deux façons de déléguer l’exploitation ; un service peut être à la fois managé et serverless, comme BigQuery. Le serverless délègue l’allocation des ressources ; les délais de démarrage, les limites d’exécution et les garanties de persistance dépendent du service.
- IAM = un principal reçoit un rôle sur une ressource ; le moindre privilège limite les droits au strict nécessaire.
- Limites du cloud = la gouvernance des données, la dépendance à la roadmap du fournisseur, et un coût à suivre dans la durée.