BigQuery : entrepôt analytique serverless
Le CM1 a posé les bases : bases de données relationnelles, entrepôts de données, modélisation et SQL. Le chapitre précédent a présenté le cloud, son élasticité et sa facturation à l’usage. BigQuery relie ces notions : vous écrivez une requête SQL ; Google gère le stockage, le calcul et l’infrastructure. L’équipe se concentre sur les données et les requêtes, tandis que le service mesure les ressources consommées.
Ce chapitre suit une seule requête, de la question métier jusqu’à la facture, puis jusqu’à son optimisation.
Objectifs
À l’issue de ce chapitre, vous saurez :
- décrire le rôle de BigQuery et nommer ses fonctions principales ;
- distinguer une charge transactionnelle (OLTP) d’une charge analytique (OLAP) ;
- expliquer comment Dremel exécute une requête sur les données de Colossus ;
- relier stockage colonnaire, colonnes lues et octets traités ;
- distinguer facturation on-demand et capacité en slots ;
- différencier partitionnement et clustering ;
- contrôler une requête avant son exécution.
Rôle et fonctions
BigQuery est l’entrepôt analytique de Google Cloud. On y dépose des tables volumineuses et on les interroge en GoogleSQL. Google gère le stockage, l’exécution et les machines. L’équipe reste responsable du schéma, des requêtes, des droits et du coût.
Il sert les analyses qui parcourent beaucoup de lignes, comme le chiffre d’affaires du Black Friday. Il ne remplace pas la base qui enregistre chaque commande.
| Fonction | À quoi elle sert |
|---|---|
| GoogleSQL | Décrire l’analyse dans une requête, sans installer de moteur |
| Exécution serverless | Obtenir du calcul pour la durée de la requête, puis le libérer |
| Stockage colonnaire | Ne lire que les colonnes citées dans le SQL |
| Séparation stockage / calcul | Les données restent stockées ; le calcul est alloué pour chaque requête, puis libéré |
| Partitionnement et clustering | Écarter les lignes qui ne peuvent pas entrer dans le résultat |
| Facturation au volume ou à la capacité | Payer les octets traités, ou des slots réservés dans le temps |
| Contrôle avant exécution | Lire l’estimation et poser un plafond d’octets avant RUN |
Ces fonctions sont le parcours du chapitre. D’autres existent, notamment BigQuery ML, la recherche vectorielle, les vues matérialisées et les requêtes planifiées ; elles ne sont pas traitées ici.
De l’OLTP à l’OLAP
Une base transactionnelle et un entrepôt analytique peuvent tous deux parler SQL, mais ils ne résolvent pas le même problème.
| OLTP : transactionnel | OLAP : analytique | |
|---|---|---|
| Finalité | Faire fonctionner l’application | Éclairer une décision |
| Opération type | Enregistrer une commande | Agréger deux ans de ventes |
| Données parcourues | Quelques lignes ciblées | Des millions ou milliards de lignes |
| Rythme | Beaucoup d’opérations courtes | Moins de requêtes, mais plus lourdes |
| Exemples | PostgreSQL, MySQL, Cloud SQL | BigQuery, Snowflake, Redshift |
BigQuery est un entrepôt analytique distribué et serverless. Il accepte aussi des opérations d’écriture, mais il est optimisé pour les analyses à grande échelle, pas pour servir chaque clic d’une application avec une latence de quelques millisecondes.
Concrètement : Cloud SQL enregistre les commandes une par une ; BigQuery analyse leur historique pour répondre au marketing.
Organisation des données dans BigQuery
Avant d’écrire une requête, il faut savoir où se trouve la donnée. Dans BigQuery, une table n’est pas isolée : elle appartient à un dataset, lui-même rattaché à un projet Google Cloud. Cette organisation sépare les données, les droits d’accès, la localisation et la facturation.
La notation complète d’une table est projet.dataset.table :
- le projet porte notamment l’IAM, les quotas et la facturation ;
- le dataset regroupe les objets dans une localisation donnée ;
- la table stocke les données et leur schéma ; une vue stocke une requête ;
- un job représente un travail soumis au service : requête, chargement, copie ou export.
La figure présente cette hiérarchie : un service BigQuery regroupe des projets, chaque projet des datasets et chaque dataset des tables. Une requête désigne d’abord ce chemin logique avant de traiter les données.
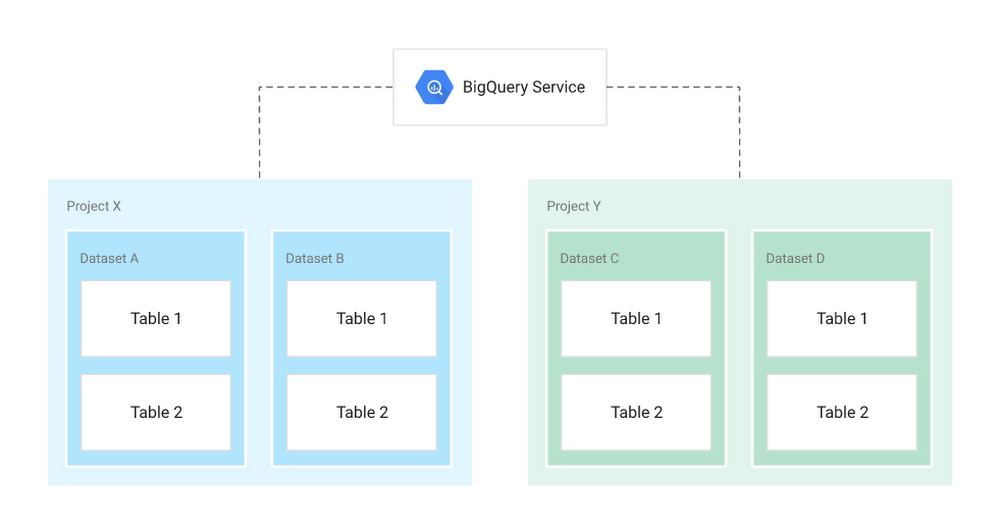
Source : Google Cloud, BigQuery explained: Storage overview, Rajesh Thallam, 2020. Figure originale Google Cloud, consultée le 6 septembre 2026.
Voici la requête fil rouge. Elle demande le chiffre d’affaires par statut pour la journée du Black Friday 2025, délimitée ici en UTC.
SELECT
  status,
  SUM(sale_price) AS chiffre_affaires
FROM `bigquery-public-data.thelook_ecommerce.order_items`
WHERE created_at >= TIMESTAMP '2025-11-28 00:00:00'
  AND created_at <  TIMESTAMP '2025-11-29 00:00:00'
GROUP BY status;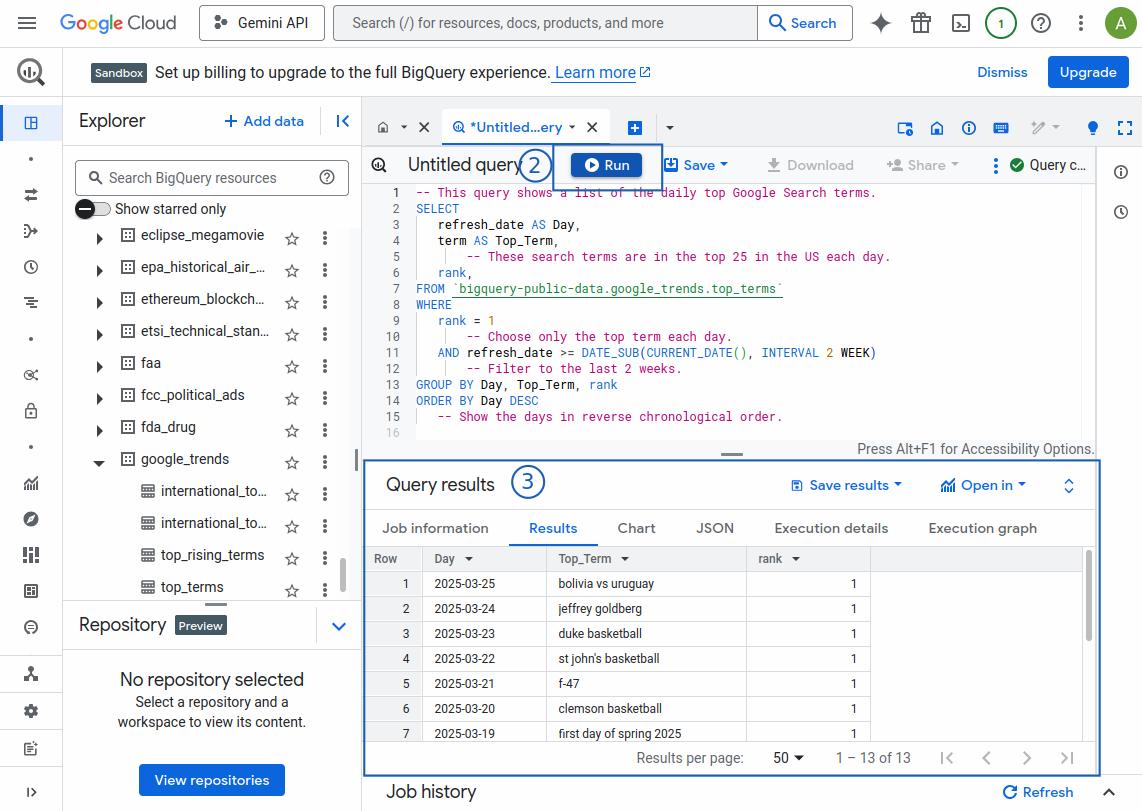 1 2 3 4
Source : LearnSQL.it, Come utilizzare Google BigQuery per esercitarsi gratuitamente con l’SQL. Capture reproduite à des fins pédagogiques, consultée le 24 septembre 2026.
La figure se lit de gauche à droite. 1 est l’explorateur : il permet de retrouver les projets, les datasets et les tables. 2 est l’éditeur dans lequel vous écrivez le GoogleSQL. Avec 3, le bouton Run, vous soumettez la requête et BigQuery crée un job. Enfin, 4 affiche les lignes produites, ainsi que les onglets donnant accès aux informations et aux détails d’exécution du job.
order_items est une table publique non partitionnée. Le WHERE created_at sélectionne les lignes du résultat, mais BigQuery lit malgré tout l’intégralité des colonnes created_at, status et sale_price. Filtrer ne coûte moins cher que si la table est organisée pour cela : c’est tout l’objet de la section sur le partitionnement, qui présente la même requête sur une copie partitionnée de la table. La section sur le stockage colonnaire expliquera d’abord pourquoi le filtre seul ne suffit pas.
Une architecture serverless
Dans une base installée sur une VM, stockage et processeurs appartiennent à la même machine ou au même cluster. BigQuery les sépare :
- les données restent dans un stockage distribué géré par Google ;
- un cluster de calcul hautement disponible traite la requête ;
- un réseau à très haut débit relie les deux ;
- la capacité de calcul est allouée dynamiquement.
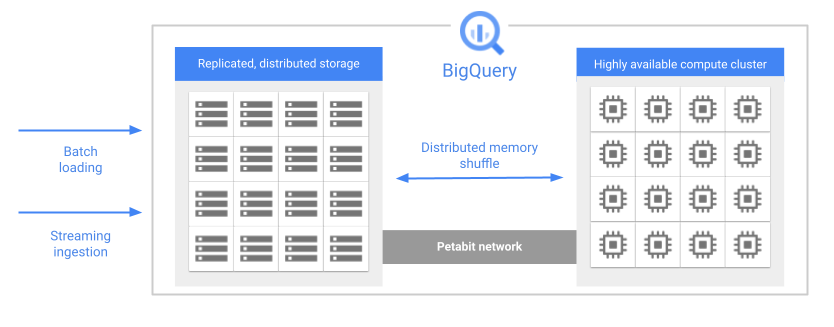
Source : Google Cloud, Overview of BigQuery storage, figure 1. Figure originale Google Cloud, consultée le 6 septembre 2026.
Pour comprendre l’architecture de BigQuery, visualisez une cuisine de restaurant : le frigo géant représente Colossus, le tapis roulant Jupiter, et le chef qui organise le travail Dremel. Les workers sont les cuisiniers qui exécutent les tâches ; les slots mesurent la capacité de calcul mise à leur disposition.
| Élément | Nature technique | Explication |
|---|---|---|
| Colossus | Système de fichiers distribué de Google (successeur de GFS) | Vos tables y reposent sous forme de fichiers colonnaires (Capacitor) répliqués. Vos données existent ici 24h/24, même si aucune requête ne tourne. Vous ne payez que les gigaoctets stockés. |
| Jupiter | Réseau interne de datacenter (débit total de l’ordre du pétabit par seconde) | C’est le « câble » ultra-rapide qui relie le stockage au calcul. Son débit permet à BigQuery de lire vos téraoctets sur des disques distants presque comme s’ils étaient locaux. |
| Dremel | Moteur de requêtage distribué (analyseur et planificateur) | Il prend votre code SQL, le découpe en centaines de petites opérations indépendantes (stages et tasks), et orchestre leur calcul pour agréger les résultats. |
| Slot | Unité de capacité de calcul (souvent comparée à un processeur virtuel) | C’est la force de travail allouée à Dremel. Selon la requête, BigQuery en mobilise quelques dizaines pendant quelques secondes ou plusieurs milliers pour une lourde jointure : ce sont des ordres de grandeur, pas des valeurs fixes. Quand la requête s’arrête, les slots sont libérés. |
Le principe clé à retenir est le suivant : le calcul ne possède pas les données. Lorsqu’une requête est lancée, Dremel réquisitionne des slots, demande à Colossus les colonnes requises, fait transiter les flux via le réseau Jupiter, calcule le résultat puis restitue les slots. En mode à la demande, une fois la requête terminée, aucun calcul supplémentaire n’est facturé ; les réservations de capacité sont présentées dans la section sur la facturation.
Dremel : diviser pour calculer en parallèle
Dremel est le moteur distribué qui reçoit le job SQL. Il transforme la requête en un graphe de stages dépendants, puis chaque stage en tâches que des workers peuvent exécuter en parallèle. Le parallélisme dépend donc du travail réellement divisible, pas seulement du nombre de slots disponibles.
L’article Dremel décrivait un arbre hiérarchique : les données sont lues en bas, agrégées à plusieurs niveaux, puis réunies dans le résultat final. L’exécution actuelle est le graphe de stages ; la figure en conserve seulement cette lecture.
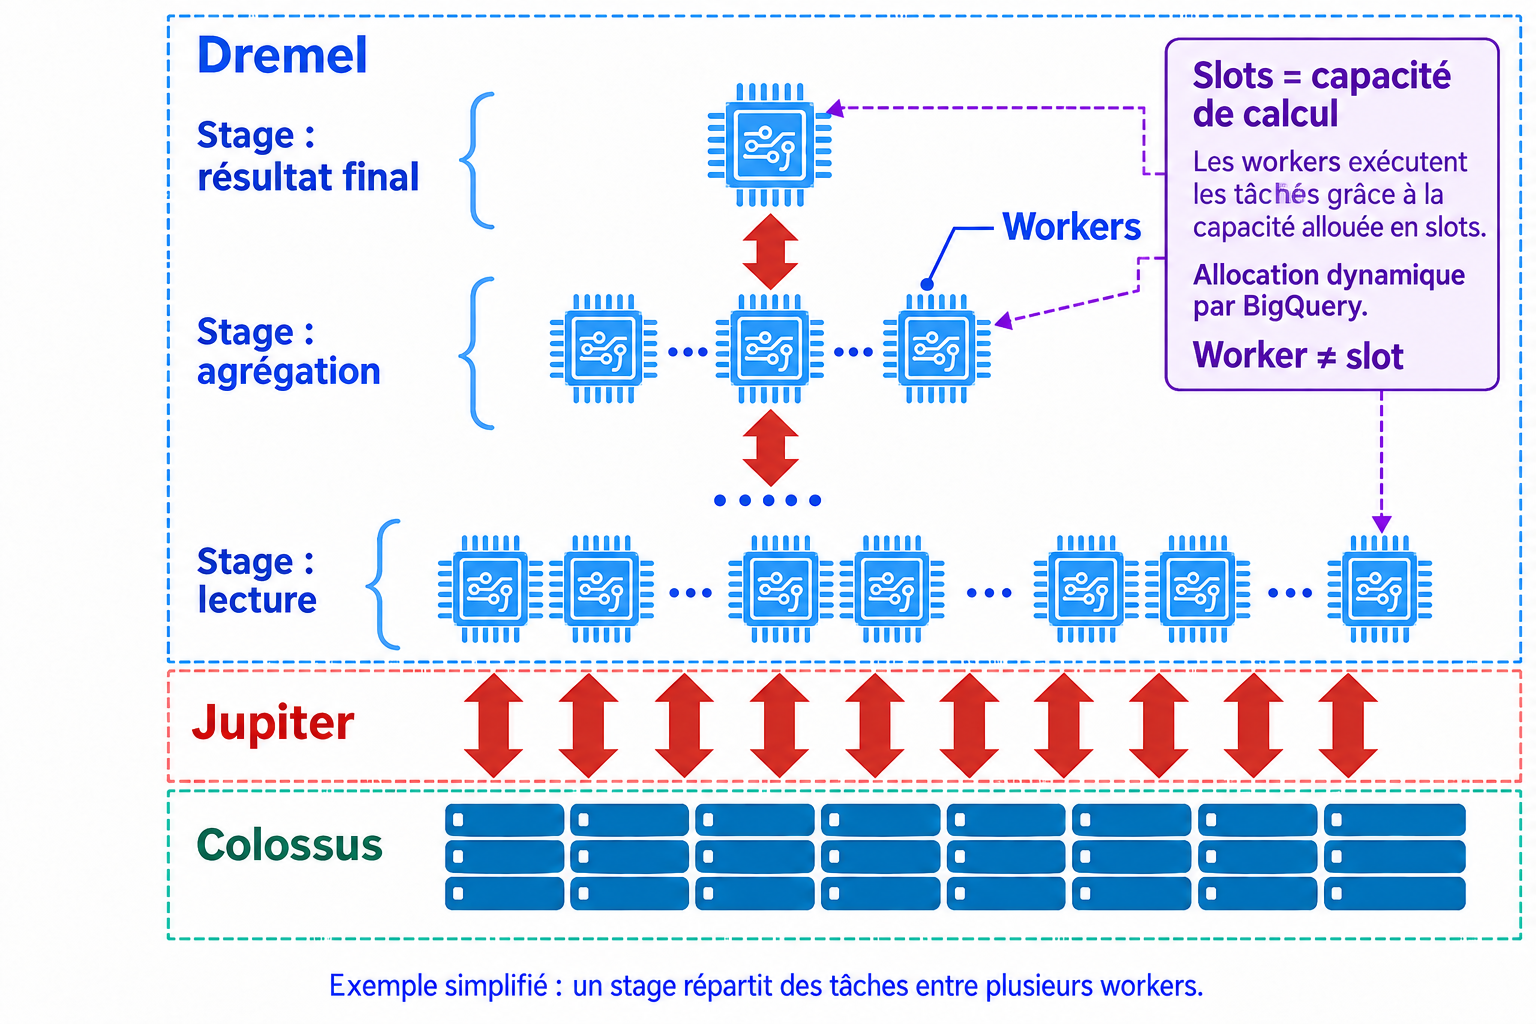
Source : Google Cloud, BigQuery explained: An overview of BigQuery’s architecture, Rajesh Thallam, 2020. Adaptation pédagogique : exemple simplifié utilisant les termes stages, tâches et workers. Les slots ne sont pas une couche supplémentaire : ils fournissent la capacité de calcul aux tâches des stages.
Dans cet exemple, les workers du stage de lecture traitent les fragments de données. Les stages suivants combinent les résultats partiels pour produire le résultat final. Les flèches violettes en pointillés relient la capacité en slots aux workers des trois stages. Elles représentent une allocation de ressources, tandis que les flèches rouges représentent les échanges de données. Un slot est une unité de capacité de calcul que BigQuery attribue dynamiquement aux tâches prêtes à s’exécuter ; un worker exécute ces tâches avec cette capacité. Le nombre de stages, l’organisation du travail et la capacité attribuée dépendent de la requête et des slots disponibles.
Reprenons la requête de chiffre d’affaires du Black Friday :
| Étape | Travail effectué |
|---|---|
| 1. Planifier | Dremel valide le GoogleSQL et construit les stages |
| 2. Lire | Des workers lisent les fragments utiles de created_at, status et sale_price |
| 3. Agréger localement | Chaque worker produit des sommes partielles de sale_price |
| 4. Redistribuer | Le shuffle regroupe les valeurs ayant la même clé status |
| 5. Fusionner | Les stages suivants additionnent les chiffres d’affaires partiels |
| 6. Restituer | Le résultat est écrit dans une table temporaire ou permanente |
Une jointure ou un GROUP BY provoque souvent un shuffle : des résultats intermédiaires changent de worker pour rapprocher les mêmes clés. Si une tâche échoue, elle peut être remise en file et reprise par un autre worker sans recommencer nécessairement toute la requête.
Un slot mesure de la capacité de calcul. Un worker exécute une tâche avec cette capacité. Aucun des deux ne désigne une machine que vous réservez ou administrez directement. Ajouter des slots n’accélère plus un stage lorsqu’il n’existe plus assez de tâches indépendantes à distribuer.
À retenir. Serverless ne veut pas dire « sans serveur ». Les serveurs existent, mais Google les exploite et les alloue. Vous restez responsable du SQL, des données, des permissions et du coût.
Le stockage colonnaire
Colossus conserve, Capacitor organise
Dremel ne peut découper la lecture en tâches parallèles que si les données sont déjà rangées pour cela. C’est le rôle de Colossus et du format Capacitor.
Colossus est la couche de persistance distribuée. BigQuery y écrit ses données en fichiers colonnaires Capacitor, découpés en fragments adaptés à la lecture parallèle. Le service gère la compression, le chiffrement, la redondance et la distribution physique.
Les métadonnées collectées sur les colonnes et les blocs aident Dremel à choisir quoi lire et comment paralléliser le travail.
Un système orienté lignes range ensemble tous les champs d’un enregistrement. C’est efficace pour retrouver ou modifier une ligne complète. BigQuery range les valeurs par colonne, ce qui convient aux agrégations portant sur peu de colonnes mais beaucoup de lignes.
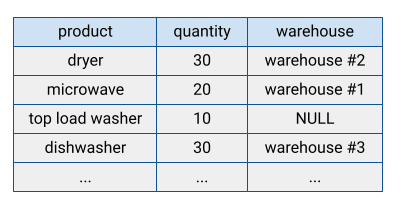
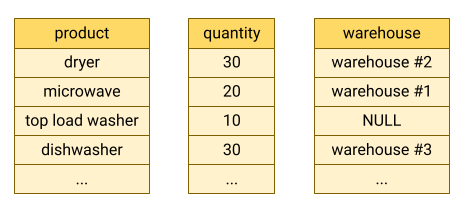
Source : Google Cloud, Overview of BigQuery storage, figures 2 et 3. Figures originales Google Cloud, consultées le 6 septembre 2026.
Comparons deux façons de commencer la même analyse sur order_items :
-- Réflexe exploratoire : toutes les colonnes sont demandées.
SELECT *
FROM `bigquery-public-data.thelook_ecommerce.order_items`;

-- Projection utile à notre question métier.
SELECT created_at, status, sale_price
FROM `bigquery-public-data.thelook_ecommerce.order_items`;
La seconde requête peut lire moins de données, car les autres colonnes ne sont pas nécessaires. Le moteur parcourt toujours beaucoup de lignes, mais ouvre moins de colonnes physiques.
Réflexe. Écrivez les colonnes utiles explicitement.
SELECT *est pratique pour explorer quelques lignes ; il devient dangereux sur une table large et volumineuse.
Pourquoi la lecture est si rapide ? Le stockage distribué de Colossus
Dans une base installée sur un serveur, la vitesse de lecture est bornée par les disques rattachés à cette machine ou à son cluster : ajouter des processeurs ne sert à rien si les disques ne suivent pas.
Dans BigQuery, c’est tout l’inverse :
- Découpage automatique en fragments (shards) : dès l’ingestion, BigQuery découpe les fichiers Capacitor en fragments indépendants, adaptés à la lecture parallèle.
- Distribution multi-disques et multi-zones : ces fragments sont répliqués sur de nombreux disques, dans différentes zones de la région, via Colossus.
- Lectures en parallèle : quand Dremel lance des workers, chacun lit un fragment sur un disque distinct.
La figure 9 montre cette répartition. La lecture est rapide parce que les workers accèdent en même temps à des fragments déjà distribués. Si un disque ou un serveur de stockage tombe en panne, un fragment répliqué prend le relais sans interrompre la requête.
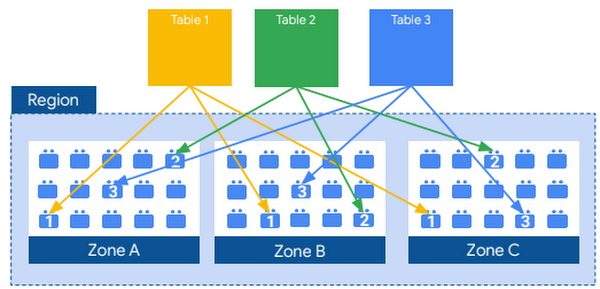
Source : Google Cloud, BigQuery explained: Storage overview, Rajesh Thallam, 2020. La figure illustre la distribution physique ; elle ne représente pas l’encodage interne d’une colonne. Figure originale Google Cloud, consultée le 6 septembre 2026.
Puisque les colonnes sont stockées séparément, le SQL détermine directement ce que Colossus doit fournir à Dremel. Ce volume lu devient maintenant une donnée économique.
Comprendre la facture
Pour les requêtes SQL sur des tables natives et le stockage étudiés dans ce chapitre, la facture BigQuery se lit principalement selon deux composantes distinctes :
- Le calcul (Dremel) : ce que consomment vos requêtes SQL ;
- Le stockage (Colossus) : ce que pèsent vos données conservées sur disque.
Ce modèle ne couvre pas tous les compteurs possibles de BigQuery : par exemple, le streaming, le Storage Read API, BI Engine ou certains transferts peuvent être facturés séparément. Pour un chiffrage de production, il faut donc partir de la grille tarifaire complète, pas uniquement de ces deux lignes.
1. Le volet calcul : facturé à la requête (octets scannés)
Dans le modèle à la demande (on-demand), le calcul est facturé exclusivement selon les octets traités par vos requêtes. Au 6 septembre 2026, le tarif de référence pour la localisation US est de 6,25 USD par Tio, au-delà du premier Tio mensuel gratuit. Ce Tio gratuit est partagé par toutes les requêtes du compte de facturation. Le prix dépend de la localisation et peut évoluer : pour un chiffrage réel, utilisez toujours la grille officielle BigQuery.
La chaîne de causalité est directe :
Plus de colonnes demandées → plus de blocs fournis par Colossus → plus d’octets traités par Dremel → plus de facture.
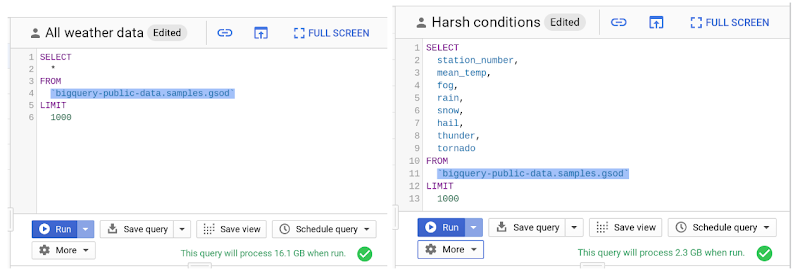
Source : Google Cloud, Cost optimization best practices for BigQuery, 2019. Capture d’une interface ancienne, portant sur une autre table que notre fil rouge ; elle est conservée pour l’ordre de grandeur du rapport entre les deux volumes. Figure originale Google Cloud, consultée le 6 septembre 2026.
Trois conséquences majeures pour le calcul
LIMIT 10ne réduit généralement pas la facture : le moteur parcourt quand même les colonnes demandées avant de ne retenir que 10 lignes. Une requête qui affiche 10 lignes peut donc coûter plusieurs dizaines de dollars si la table fait plusieurs téraoctets. Sur une table clusterisée,LIMITpeut réduire les octets lus si BigQuery peut arrêter le scan après avoir parcouru suffisamment de blocs pour produire le résultat ; cela ne nécessite pas systématiquement un filtre ou un tri sur les colonnes de clustering. Le gain dépend de la requête et doit être mesuré. Voir les règles de coût de LIMIT.- La projection explicite est obligatoire : bannissez les
SELECT *. Ne demandez que les colonnes indispensables. - Une réponse servie depuis le cache n’est pas facturée comme une nouvelle requête : lorsque le résultat en cache est réutilisable, BigQuery le renvoie avec
cacheHit = trueet 0 octet traité. Relancer une requête identique ne garantit pas une réponse en cache. En TP, désactivez le cache pour mesurer vos optimisations.
« Identique » est plus exigeant qu’il n’y paraît, et c’est la première source de mesures incohérentes en TP. Le cache ne s’applique pas si le texte de la requête diffère ne serait-ce que d’un espace ou d’un commentaire, si une table référencée a été modifiée depuis, si la requête appelle une fonction non déterministe comme CURRENT_TIMESTAMP(), ou si elle écrit dans une table de destination. Le cache est conservé généralement autour de 24 heures, sans garantie de disponibilité. Les éditions Enterprise et Enterprise Plus permettent aussi la réutilisation de résultats entre utilisateurs autorisés d’un même projet. Vérifiez toujours cacheHit dans les détails du job. Voir la documentation du cache.
Avant RUN, l’éditeur affiche une estimation des octets qui seront traités. Cette estimation doit devenir aussi naturelle que la lecture d’un plan d’exécution en SQL.
Calcul oral
Imaginons un tableau de bord qui rejoue cette analyse cent fois dans le mois, chaque exécution lisant 100 Gio. Le volume traité atteint 10 000 Gio, soit environ 9,77 Tio. Au tarif de référence de 6,25 USD/Tio, la facture de calcul s’élève à environ 61 USD, ramenés à 55 USD si ce tableau de bord est le seul à consommer le Tio gratuit du compte. Ni la durée des requêtes ni le nombre de lignes affichées n’entrent dans ce calcul : seuls comptent les octets traités.
Le même raisonnement s’applique à un tableau de bord branché en direct sur une table volumineuse, par exemple dans Looker Studio, l’outil de visualisation de Google : les consultations qui déclenchent une nouvelle requête non servie depuis un cache peuvent entraîner des octets facturés.
2. Le volet stockage : facturé en continu (Go conservés)
Le calcul n’est facturé que lorsqu’une requête s’exécute. À l’inverse, le stockage est facturé en continu, 24h/24, que la table soit interrogée ou non.
Deux règles simples régissent ce coût :
- Stockage actif vs longue durée : les tables ou partitions modifiées dans les 90 derniers jours sont en stockage actif (~0,02 $/Gio/mois). Au-delà de 90 jours sans modification, BigQuery bascule automatiquement vos données en stockage longue durée (environ moitié prix, ~0,01 $/Gio/mois), avec des performances de lecture strictement identiques.
- Stockage logique vs physique : vous pouvez choisir d’être facturé au volume de données brutes (logique) ou au volume réellement compressé sur disque (physique). Le tarif unitaire du modèle physique est plus élevé et inclut les octets conservés pour le voyage dans le temps (time travel) et la sécurité intégrée (fail-safe) : il n’est avantageux que lorsque les données se compressent bien.
Les 10 premiers Gio de stockage sont gratuits chaque mois. Un pipeline qui empile des données sans jamais fixer de date d’expiration verra donc sa facture enfler silencieusement chaque mois, même si plus personne n’ouvre la table : une expiration de partition est le garde-fou le plus simple.
Octets à la demande ou capacité en slots
Les slots rencontrés dans Dremel deviennent ici un second compteur économique. BigQuery propose deux façons principales de payer le calcul :
| On-demand | Capacité | |
|---|---|---|
| Compteur | Octets traités | Capacité en slots allouée dans le temps |
| Adapté à | Charge occasionnelle ou imprévisible | Charge régulière, importante ou à isoler |
| Pilotage | Réduire les données lues | Configurer réservations, baseline et autoscaling |
| Prévisibilité | Dépend du volume des requêtes | Dépend de la capacité configurée et consommée |
Une édition (Standard, Enterprise, Enterprise Plus) détermine le tarif du slot et les fonctionnalités disponibles. Une réservation définit une capacité affectée aux charges de travail. Sa baseline correspond aux slots constamment alloués et facturés, même lorsqu’ils sont inoccupés.
L’autoscaling ajoute de la capacité selon la demande, jusqu’au maximum configuré pour la réservation. La facturation porte sur la capacité allouée dans le temps, qui peut dépasser le nombre de slots effectivement occupés par les tâches. Les incréments d’allocation et les durées minimales de facturation dépendent des règles applicables.
Une baseline à zéro permet de s’appuyer sur l’autoscaling. Une baseline plus élevée rend davantage de capacité immédiatement disponible, mais ne garantit pas à elle seule la performance : celle-ci dépend aussi du SQL, du parallélisme et de la concurrence entre jobs. Voir la documentation des slots et de l’autoscaling.
Le planificateur répartit dynamiquement cette capacité entre les requêtes actives ; lorsqu’une requête se termine, ses slots redeviennent disponibles.
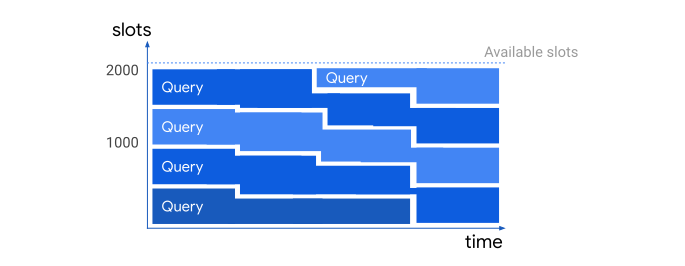
Source : Google Cloud, Understand slots. Figure originale Google Cloud, consultée le 6 septembre 2026.
Il n’existe pas de seuil universel à partir duquel la capacité devient moins chère. La décision dépend de la région, de l’édition, de la concurrence et du profil des jobs. Le Slot Estimator exploite l’historique de la charge pour comparer les configurations.
Partitionnement et clustering
Lire moins de colonnes est un premier levier. Il faut aussi éviter de lire les lignes qui ne peuvent pas contribuer au résultat.
| Partitionnement | Clustering | |
|---|---|---|
| Organisation | Découpe la table en partitions | Trie et regroupe les données en blocs |
| Colonne typique | Date, timestamp ou plage d’entiers | Colonnes souvent filtrées ou regroupées |
| Élimination | Partition pruning | Block pruning |
| Estimation avant exécution | Les partitions éliminées sont prises en compte | Le gain exact des blocs est connu à l’exécution |
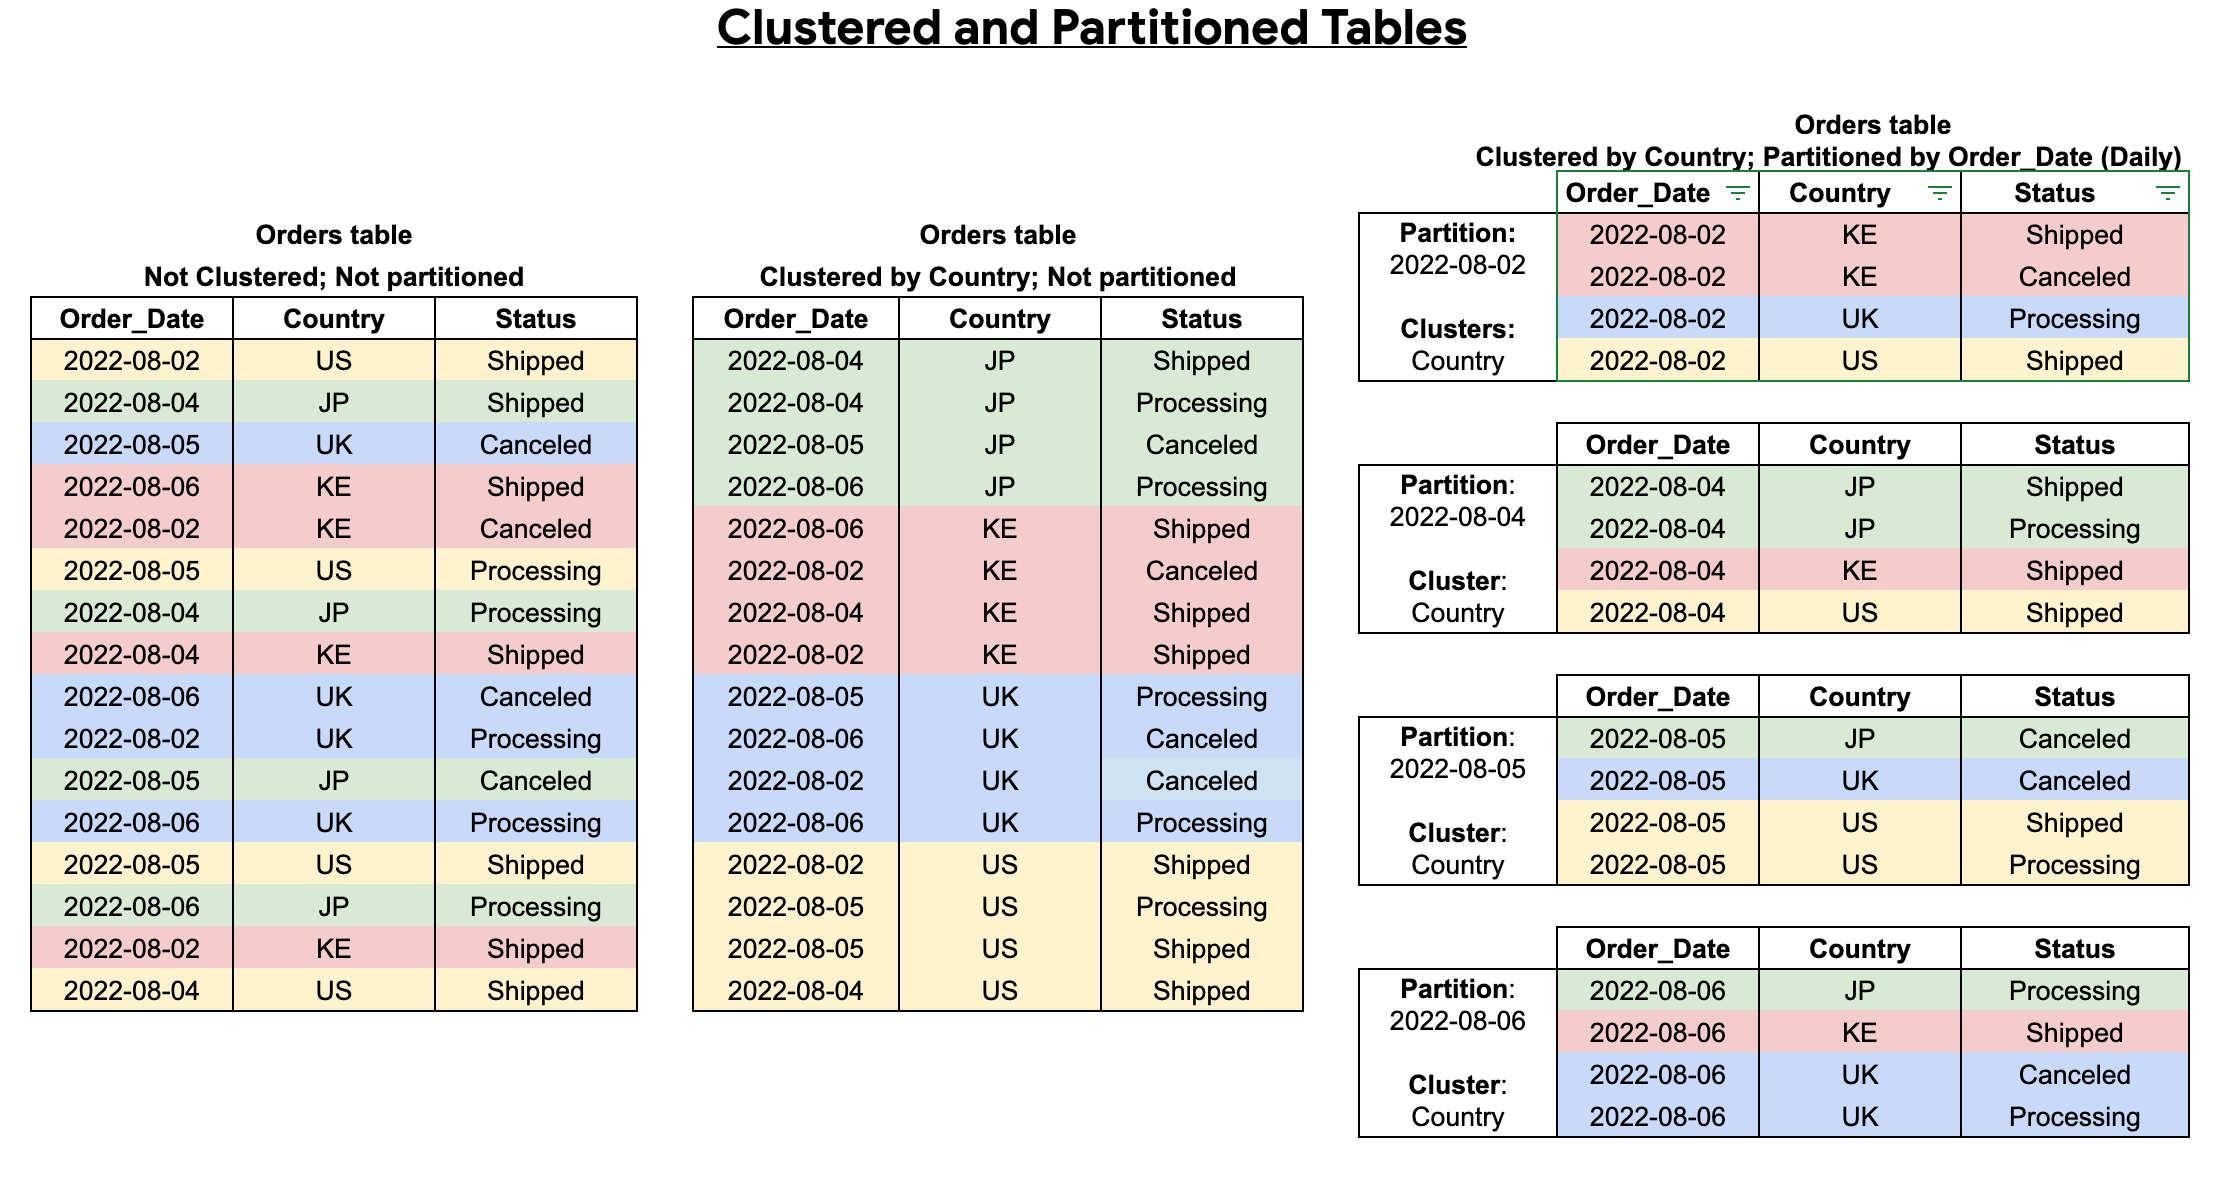
Source : Google Cloud, Introduction to clustered tables. Figure originale Google Cloud, consultée le 6 septembre 2026.
Remplacez votre-projet par votre projet d’exercice. Créez le dataset cm2 dans la même localisation que la source. La création de la table nécessite les droits BigQuery correspondants.
Exécutez cette création une seule fois. CREATE TABLE n’écrase pas une table existante.
CREATE TABLE `votre-projet.cm2.order_items_part`
PARTITION BY DATE(created_at)
CLUSTER BY status
AS
SELECT created_at, status, sale_price
FROM `bigquery-public-data.thelook_ecommerce.order_items`;
Voir la création de tables partitionnées. La copie reflète la source au moment de sa création.
SELECT
  status,
  SUM(sale_price) AS chiffre_affaires
FROM `votre-projet.cm2.order_items_part`
WHERE created_at >= TIMESTAMP '2025-11-28 00:00:00'
  AND created_at <  TIMESTAMP '2025-11-29 00:00:00'
  -- À ajouter si l'analyse ne porte que sur ces statuts :
  -- AND status IN ('Complete', 'Shipped')
GROUP BY status;
La copie créée ci-dessus est partitionnée sur DATE(created_at) et clusterisée par status ; elle appartient à votre projet. Les bornes temporelles permettent à BigQuery d’ignorer les autres partitions : c’est le partition pruning. Si l’analyse est restreinte à certains statuts, le prédicat status IN (...) peut ensuite éliminer des blocs : c’est le block pruning. Un GROUP BY status sans filtre sur status ne suffit pas, à lui seul, à promettre cet élagage.
Le fil complet devient visible : la projection limite les colonnes, le partitionnement limite la période, le clustering peut limiter les blocs, puis le shuffle ne redistribue que les données restantes.
Formulation exacte. Partitionner une table ne rend pas toutes ses requêtes moins chères. C’est un filtre exploitable sur la colonne de partition qui permet d’éviter des partitions.
BigQuery ne repose pas principalement sur les index B-tree traditionnels d’un système OLTP. Le partitionnement et le clustering organisent les données pour réduire le scan analytique. BigQuery propose aussi des index spécialisés, notamment des index de recherche, pour des cas d’usage ciblés : ils ne remplacent pas les deux mécanismes précédents.
Les chiffres de l’avant/après ne sont volontairement pas donnés ici : vous les produirez vous-même pendant le TP, sur ses propres tables, et les comparerez ensuite aux mesures de référence. Un gain annoncé à l’avance n’apprend rien ; un gain mesuré sur sa propre requête, si.
Avant d’exécuter
La pratique professionnelle tient dans une boucle plutôt que dans une liste de recettes :
Estimer → Exécuter → Observer → Optimiser → Comparer
| Étape | Action |
|---|---|
| Estimer | Lire l’estimation affichée en haut à droite de l’éditeur, ou lancer un dry run |
| Exécuter | Fixer un plafond maximum_bytes_billed : la requête échoue au lieu de coûter |
| Observer | Contrôler octets traités, cache, stages et shuffle |
| Optimiser | Revoir colonnes, partitions, clustering, grain et jointures |
| Comparer | Rejouer dans les mêmes conditions, avec le cache maîtrisé |
BigQuery distribue correctement une requête techniquement valide ; il ne sait pas si une jointure multiplie accidentellement le chiffre d’affaires. Le serverless retire l’administration des machines, pas la responsabilité sur le grain, la qualité des clés, l’IAM ou le coût.
- BigQuery = l’entrepôt analytique serverless de Google Cloud. L’équipe écrit le SQL ; Google gère le stockage, le calcul et les machines.
- OLTP et OLAP = la base transactionnelle enregistre chaque commande. BigQuery analyse l’historique, sans remplacer cette base.
- Dremel, Colossus et slots = Dremel exécute la requête en parallèle, Colossus conserve les données, les slots fournissent la capacité de calcul puis sont libérés.
- Stockage colonnaire = seules les colonnes citées dans le SQL sont lues. Les octets traités dépendent de ce volume.
- On-demand et slots = à la demande, on paie les octets traités. En capacité, on réserve des slots dans le temps.
- Partitionnement et clustering = le partitionnement écarte des partitions, le clustering peut écarter des blocs. Un filtre sur la colonne concernée est nécessaire.
- Avant RUN = estimer, poser un plafond d’octets, puis comparer. Une requête peu chère mais fausse reste une mauvaise requête.