Modélisation de données
Modéliser des données, c’est représenter de façon structurée les éléments d’un domaine et les liens qui les unissent. Cette démarche permet de structurer les données en fonction de la manière dont elles seront stockées et exploitées.
Selon l’usage prévu, on peut privilégier la normalisation, qui limite les redondances et facilite les mises à jour, ou la dénormalisation, qui simplifie la lecture et les requêtes d’analyse.
Pour passer progressivement de cette représentation générale à sa mise en œuvre concrète, on distingue trois niveaux de modélisation :
- Le modèle conceptuel décrit les objets métier et leurs relations, indépendamment du système de gestion de base de données et des choix techniques de mise en œuvre. Il répond à la question : que veut-on représenter ?
- Le modèle logique organise les données en tables et définit leurs relations. Pour l’analyse, on peut choisir un schéma en étoile ou en flocon. Il répond à la question : comment organiser les données pour l’usage prévu ?
- Le modèle physique précise leur organisation physique dans le moteur choisi, notamment le partitionnement et le clustering. Il répond à la question : comment stocker et parcourir les données efficacement ?
Décrire le métier : le modèle entité-association
Avant d’organiser les données en tables, il faut répondre à deux questions : quels objets métier veut-on décrire, et quelles règles les relient ?
Entités, attributs et identifiants
Le modèle entité-association représente ces objets et leurs relations, avant toute décision technique. Il distingue :
- les entités, comme un client, une transaction ou un produit ;
- les attributs, qui décrivent leurs propriétés : nom, date, quantité ;
- les associations, qui expriment leurs relations : un client effectue une transaction, une transaction contient des lignes de vente.
Chaque occurrence d’une entité possède un identifiant. Par exemple, id_transaction distingue les transactions.
Associations et cardinalités
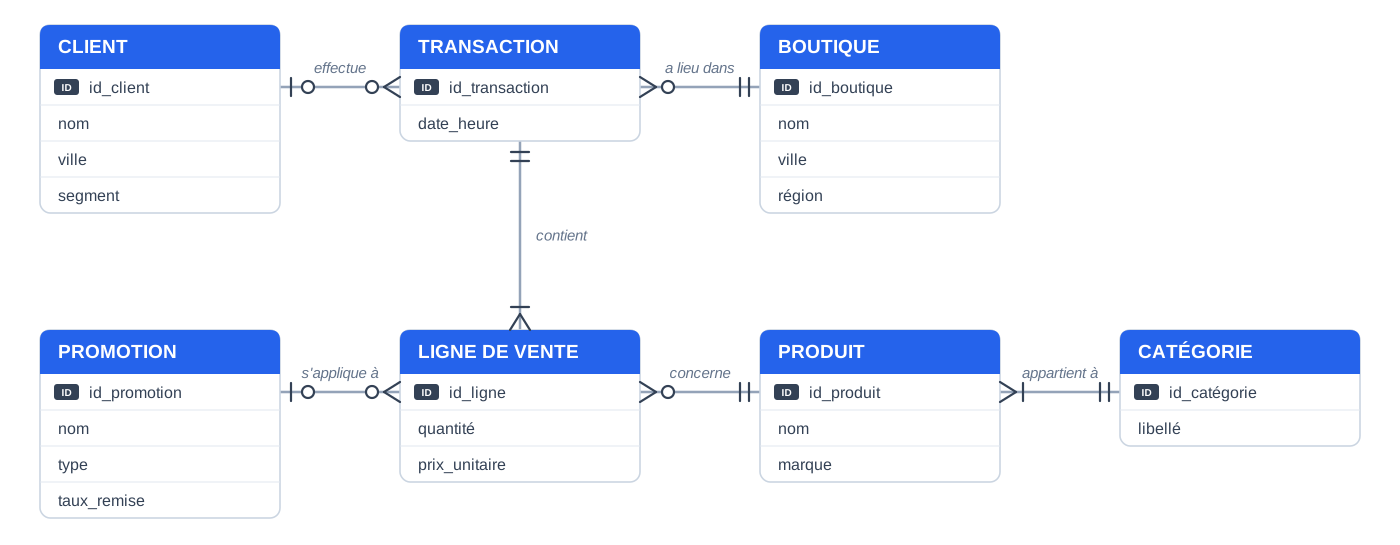
La figure 21 illustre les règles de gestion retenues. Chaque transaction a lieu dans une boutique, comporte au moins une ligne de vente et peut être associée à un client ou rester anonyme. Chaque ligne concerne un produit et peut bénéficier d’une promotion. Enfin, chaque produit appartient à une catégorie. Ces règles s’expriment, dans le schéma, par des cardinalités, qui indiquent combien d’occurrences d’une entité peuvent être reliées à une autre. La notation en patte d’oie, ou crow’s foot, les inscrit à chaque extrémité du lien.
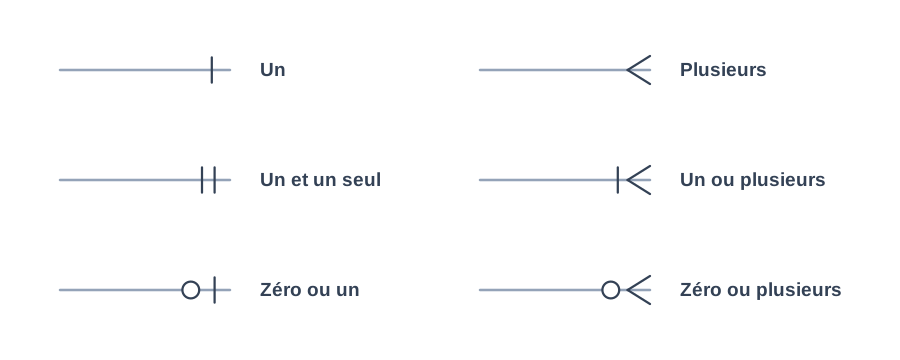
Chaque terminaison combine une cardinalité minimale (zéro ou un : relation facultative ou non) et une cardinalité maximale (un ou plusieurs : la relation peut se répéter). Trois symboles :
- le cercle : zéro, relation facultative ;
- la barre : un, relation obligatoire ou unique ;
- la patte d’oie : plusieurs.
Quel que soit l’outil utilisé, les cardinalités expriment les mêmes règles. Par exemple :
- un client effectue zéro ou plusieurs transactions : cercle et patte d’oie ;
- une ligne appartient à une et une seule transaction : double barre.
Passer du modèle aux tables
Lors du passage aux tables, les attributs deviennent des colonnes et les identifiants permettent de définir les clés primaires. Les associations sont traduites selon leurs cardinalités. Par exemple, chaque détail de transaction concerne un seul produit : la table de détail des transactions porte une clé étrangère vers la table des produits.
Les contraintes rendent ces règles vérifiables : une clé primaire identifie chaque ligne, une clé étrangère référence une autre table, NOT NULL impose une valeur, UNIQUE interdit les doublons et CHECK vérifie une condition.
Organiser les données pour l’analyse
Dans le chapitre précédent, la troisième forme normale (3NF) visait à limiter les répétitions de données et les anomalies de mise à jour. Pour faciliter l’analyse, un modèle dimensionnel peut faire le choix inverse : la dénormalisation rassemble dans une même table des informations qui seraient réparties dans plusieurs tables. Elle simplifie les requêtes et réduit les jointures, mais introduit de la redondance et demande une attention particulière lors des mises à jour.
Le passage aux tables traduit les règles métier dans une base de données relationnelle. Lorsqu’on souhaite analyser les ventes, il faut ensuite organiser les données pour faciliter les requêtes : les mesures sont regroupées dans une table de faits, tandis que les informations de contexte sont placées dans des dimensions. Les schémas en étoile et en flocon sont deux façons de réaliser cette organisation.
Le schéma en étoile (star schema)
Le modèle dimensionnel, formalisé par Ralph Kimball, organise les données pour faciliter leur analyse. Il range d’un côté les chiffres à analyser, de l’autre les informations qui les décrivent. Au centre, une table de faits enregistre les événements métier et leurs mesures. Autour, des tables de dimensions décrivent le contexte de ces événements (quand, quoi, qui, où), de façon volontairement aplatie.
À partir de ce modèle, les tables et les colonnes portent des noms anglais, comme c’est l’usage dans la plupart des entrepôts de données : le client devient customer, la boutique store, le produit product et la ligne de vente sales_line.
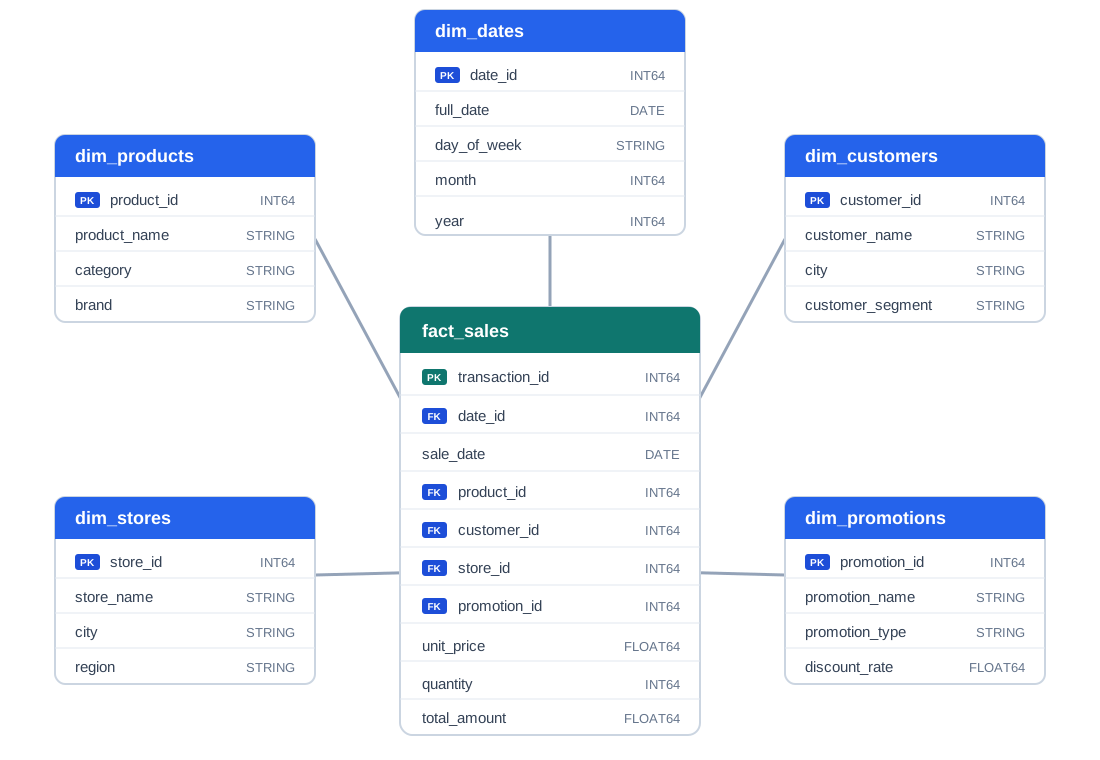
fact_sales porte les mesures et une clé étrangère par dimension ; les dimensions sont disposées autour.Grain : une ligne de produit vendue dans une transaction. Le nommage
fact_ / dim_ distingue visuellement les deux rôles.
On lit la figure dans l’ordre de la conception.
- Granularité. Ce que représente une ligne de faits, ici une ligne de produit vendue dans une transaction. Elle se décide d’abord, car elle fixe la signification de chaque mesure :
quantitycompte des unités vendues d’un produit dans un tickettransaction_id. - Dimensions. Les tables autour (date, produit, client, boutique, promotion) répondent chacune à une question de contexte. Chacune porte une clé primaire (
PK) et des attributs descriptifs, ceux que l’analyste utilisera pour filtrer et regrouper. - Table de faits. Au centre,
fact_salesest la seule table qui porte des clés étrangères (…_id, badgeFK), une par dimension. Chaque transaction est identifiée partransaction_id. La colonnesale_daterecopie la date de la vente : elle servira à partitionner la table. - Mesures. Les valeurs numériques que l’on agrège.
quantityettotal_amountsont additives : leur somme a un sens sur n’importe quel axe.unit_pricene l’est pas : on en calcule une moyenne, jamais une somme.
La forme en étoile tient en une règle : chaque dimension est reliée à la table de faits par une seule jointure, et aucune dimension n’est reliée à une autre.
Cette organisation rend les chemins de jointure explicites. Pour l’analyste, une question métier se lit directement sur le schéma. « Quantités vendues par catégorie et par ville de boutique » : la catégorie est dans dim_products, la ville dans dim_stores, la quantité dans fact_sales. Il suffit de trois tables et de deux jointures.
Le prix à payer est la redondance. Dans dim_products, category et brand sont recopiées sur chaque produit : renommer une catégorie oblige à modifier toutes les lignes qui la portent. C’est exactement l’anomalie que la troisième forme normale évitait.
Le schéma en flocon (snowflake schema)
Reprenons le modèle de ventes de la figure 23. Dans dim_products, le nom d’une catégorie est répété pour chaque produit qui lui appartient ; celui d’une marque, pour chaque produit de cette marque. On peut réduire cette répétition en appliquant la normalisation aux dimensions.
Dans la figure 24, les catégories et les marques sont stockées dans deux tables distinctes, dim_categories et dim_brands. La table dim_products les référence par les clés étrangères category_id et brand_id. Le même principe est appliqué aux clients : leur ville est décrite dans dim_cities, référencée par city_id.
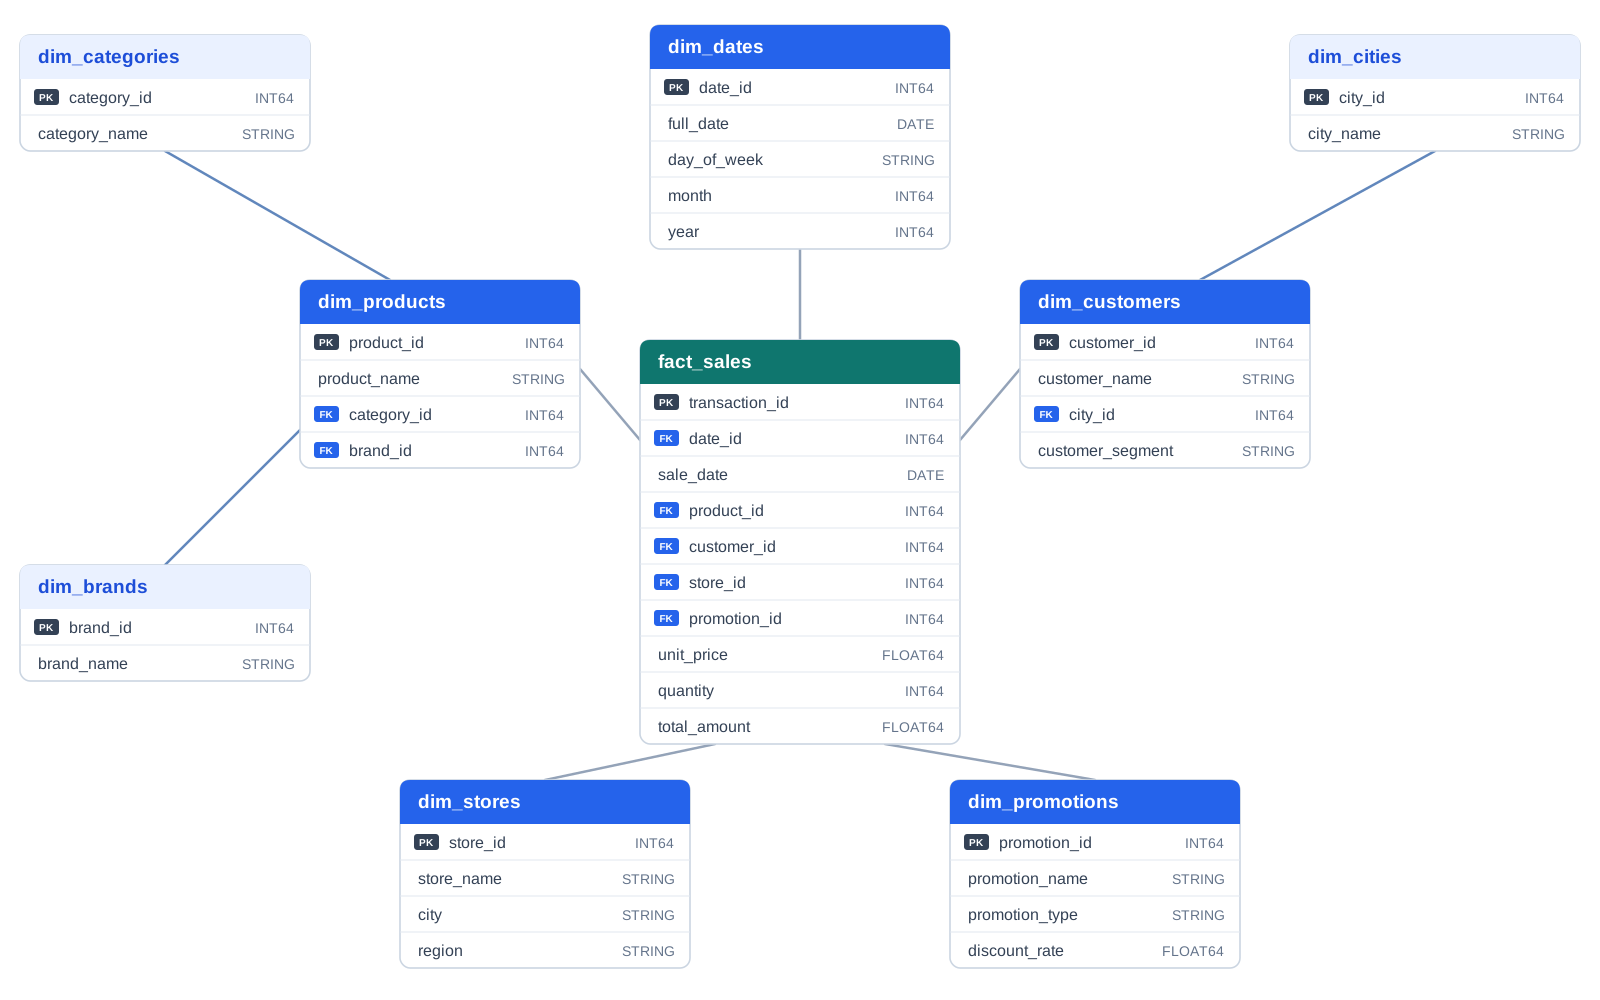
fact_sales. Les dimensions produit et client se prolongent vers des tables de catégories, de marques et de villes, représentées en bleu clair.
C’est cette décomposition de certaines dimensions en plusieurs tables liées qui caractérise le schéma en flocon. Toutes les dimensions ne doivent pas nécessairement être décomposées : dans cet exemple, les dates, les boutiques et les promotions restent dans une seule table chacune.
La transformation porte sur la description du contexte, pas sur les ventes enregistrées. La table fact_sales conserve ses mesures, ses clés étrangères et sa granularité : une ligne de produit vendue dans une transaction.
Pour comprendre la conséquence sur les requêtes, comparons une même question : quelle quantité a été vendue par catégorie de produit ?
Dans l’étoile, la catégorie figure directement dans dim_products. Une seule jointure avec fact_sales suffit. Dans le flocon, il faut d’abord rejoindre dim_products, puis dim_categories pour retrouver le nom de la catégorie. La même analyse demande donc deux jointures.
| Critère | Étoile | Flocon |
|---|---|---|
| Organisation des dimensions | Une table par dimension | Certaines dimensions réparties entre plusieurs tables liées |
| Nom de catégorie | Répété dans les lignes des produits concernés | Stocké dans une table de catégories |
| Ventes par catégorie, dans cet exemple | Une jointure | Deux jointures |
| Exploration directe du modèle | Moins de relations à parcourir | Davantage de relations à parcourir |
Le flocon réduit ainsi la répétition des libellés. Corriger le nom d’une catégorie peut se faire dans une seule ligne de dim_categories. En contrepartie, les requêtes qui utilisent ce nom doivent parcourir une relation supplémentaire.
L’étoile est généralement privilégiée lorsque les analystes explorent directement le modèle : les attributs nécessaires aux filtres et aux regroupements sont réunis dans les dimensions. Le flocon peut être retenu lorsqu’on souhaite gérer séparément certaines catégories ou certains référentiels. Le choix dépend des usages, des traitements de chargement et du moteur de données.
Enfin, partager une dimension entre plusieurs tables de faits n’impose pas un flocon : une même dimension produit ou date peut aussi être commune à plusieurs schémas en étoile.
Organiser le stockage : partitionnement et clustering
Après avoir choisi les tables et leurs relations, on s’intéresse à leur stockage. Une requête limitée à une journée ne devrait pas avoir à parcourir tout l’historique des ventes. L’organisation physique vise à limiter les données lues pour répondre à la question.
L’indexation accélère les requêtes en créant des index sur les colonnes filtrées ou jointes : c’est le réflexe des bases transactionnelles. Sur un entrepôt comme BigQuery, deux autres leviers prennent le relais :
- Le partitionnement découpe la table en segments, souvent un par date. Filtrer sur une date élimine directement les segments qui ne concernent pas ce jour.
- Le clustering trie les lignes à l’intérieur de chaque segment, par exemple par pays. Filtrer sur le pays permet alors de ne lire que les blocs concernés dans le segment, sans parcourir les autres pays du même jour.
Le partitionnement réduit le nombre de segments à lire ; le clustering réduit ce qu’on lit dans chaque segment. On les combine : d’abord les jours, ensuite le pays à l’intérieur de chaque jour.
Dans notre modèle de ventes, fact_sales est partitionnée sur sale_date. C’est pour cette raison que la table de faits porte la date de vente en clair, en plus de la clé date_id qui la relie à dim_dates.

Source : Google Cloud, « Introduction aux tables en cluster ».
De gauche à droite :
- Non organisée. Les lignes sont dans l’ordre d’arrivée. Une requête sur une date parcourt tout.
- Clusterisée. Même contenu, trié par
Country. Le clustering réorganise, il ne découpe pas. - Partitionnée et clusterisée. Un segment par
Order_Date, et à l’intérieur un tri parCountry.
Le gain est donc double : le partitionnement limite le volume ouvert, le clustering affine encore ce volume. Ce second gain n’est pas automatique. Il dépend des colonnes filtrées : le clustering profite surtout aux requêtes qui filtrent sur la première colonne de clustering, puis éventuellement sur les suivantes. Une requête qui filtre seulement sur la deuxième colonne en tire beaucoup moins parti. L’ordre des conditions dans la clause WHERE, en revanche, n’a aucune importance.
Interroger le modèle : une requête analytique
Le modèle peut maintenant être interrogé. L’exemple suivant combine six éléments courants d’une requête analytique.
| Clause | Rôle |
|---|---|
SELECT |
Choisir les colonnes et les mesures calculées |
FROM … JOIN … ON |
Désigner la table de départ et lier les tables associées |
WHERE |
Filtrer les lignes, avant tout regroupement |
GROUP BY |
Regrouper les lignes selon une ou plusieurs colonnes |
HAVING |
Filtrer les groupes, après agrégation |
ORDER BY |
Trier le résultat |
Appliquée au schéma en étoile des ventes, une requête complète prend la forme suivante.
SELECT p.category,
       s.city,
       SUM(v.total_amount) AS chiffre_affaires
FROM fact_sales AS v
JOIN dim_products AS p ON v.product_id = p.product_id
JOIN dim_stores AS s ON v.store_id = s.store_id
WHERE v.sale_date BETWEEN DATE '2024-01-01' AND DATE '2024-12-31'
GROUP BY p.category, s.city
HAVING SUM(v.total_amount) > 100000
ORDER BY p.category, s.city;
Le filtre porte directement sur v.sale_date, la colonne de partitionnement. BigQuery peut ainsi ne lire que les partitions de la période demandée.
- Entités et cardinalités. Les entités représentent les objets ou événements du métier. Les cardinalités précisent combien d’occurrences peuvent être liées et si le lien est obligatoire ou facultatif.
- Grain. Le grain définit ce que représente une ligne de la table de faits.
- Faits et dimensions. Les faits portent les mesures à analyser. Les dimensions décrivent le contexte utilisé pour les filtrer et les regrouper.
- Dénormalisation. Elle rassemble des informations réparties entre plusieurs tables. Elle simplifie les requêtes et réduit les jointures, mais répète des données et complique la cohérence des mises à jour.
- Étoile et flocon. L’étoile regroupe les attributs de chaque dimension dans une table. Le flocon répartit certains attributs entre plusieurs tables liées : moins de répétition, mais davantage de jointures pour y accéder.
- Partitionnement et clustering. Le partitionnement sépare les données selon une colonne. Le clustering rapproche les lignes ayant des valeurs similaires dans les colonnes choisies. Ces deux techniques permettent de lire moins de données lorsque les requêtes filtrent directement sur ces colonnes.
- SQL analytique.
WHEREfiltre les lignes,GROUP BYles regroupe et les fonctions d’agrégation calculent les mesures.HAVINGfiltre les groupes après l’agrégation.