Apache Spark : comprendre le calcul distribué avec les RDD
Lorsque le volume de données augmente, une seule machine peut manquer de mémoire ou mettre beaucoup de temps à terminer un traitement. Une solution consiste à répartir les données et le travail entre plusieurs machines : c’est le principe du calcul distribué.
Apache Spark permet d’exécuter des traitements de façon distribuée. Nous découvrirons son architecture interne, notamment le rôle de chaque composant : le driver, le gestionnaire de cluster, les workers et les executors.
Nous découvrirons comment manipuler les RDD à l’aide de transformations pour définir les calculs et d’actions pour les exécuter.
Objectif du chapitre
À l’issue de ce chapitre, vous saurez :
- Expliquer le calcul distribué : répartir les données et le travail entre plusieurs machines.
- Décrire le rôle des composants de Spark : driver, gestionnaire de cluster, workers et executors.
- Créer un RDD et comprendre comment ses éléments sont répartis en partitions.
- Distinguer les transformations des actions et expliquer quand Spark exécute un calcul.
- Suivre l’exécution d’un traitement : tâches, stages et échanges de données entre partitions.
- Expliquer le recalcul d’une partition perdue grâce au lineage.
Pourquoi utiliser Spark ?
L’illustration ci-dessous compare l’évolution du temps d’exécution avec Pandas et Spark lorsque la taille des données augmente :
- Pandas : la courbe s’arrête vers 15 Go avec une erreur MemoryError.
- Spark : le traitement se poursuit au-delà de ce volume dans l’illustration.
Faites défiler le graphique horizontalement sur petit écran.
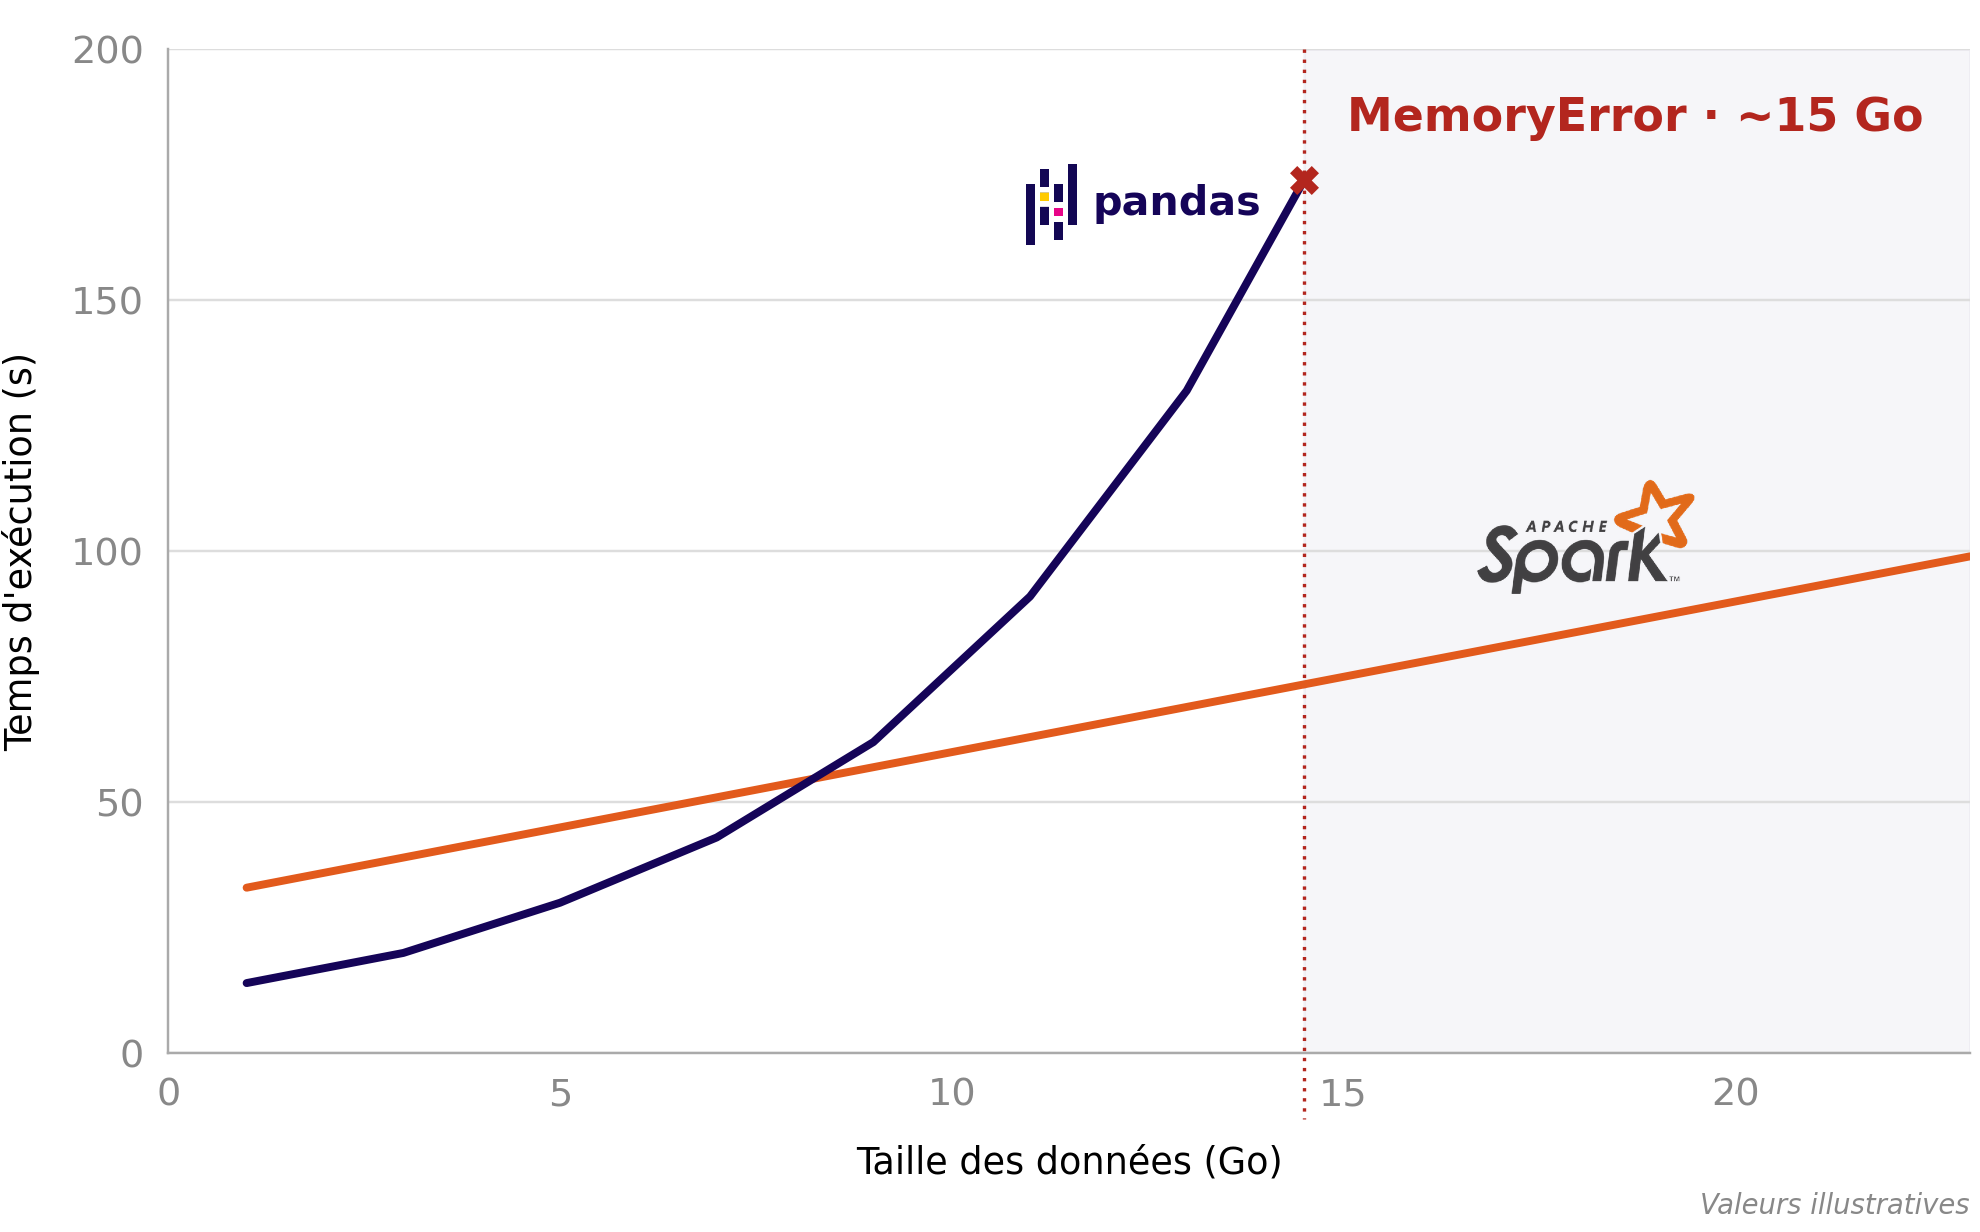
Pour de petits volumes, Pandas suffit souvent. Lorsque le volume augmente, la mémoire vive (RAM) disponible et le temps de calcul peuvent devenir des contraintes. Spark permet de répartir les données et le calcul entre plusieurs machines pour accélérer le traitement de grands volumes et limiter le risque de saturation mémoire (Out of Memory).
Spark : un outil de référence du big data
- Netflix : des milliards d’enregistrements par jour. En 2020, Netflix décrit Bulldozer, un système utilisant Spark pour transférer ces données depuis son entrepôt vers les bases utilisées par ses services, notamment pour la personnalisation. Source : Netflix TechBlog.
- Uber : 10 000 traitements Spark par jour. En 2018, Uber décrit une plateforme analytique contenant plus de 100 Po de données, sur laquelle ses équipes utilisent notamment Spark pour programmer leurs traitements. Ce volume correspond à la plateforme entière. Source : Uber Engineering.
- eBay : une plateforme de plus de 20 Po. En 2021, eBay présente son moteur Spark SQL optimisé, utilisé en production pour les analyses interactives après la migration de ce volume de données vers sa plateforme Hadoop. Source : eBay Engineering.
- Facebook : 60 To dans un même traitement. En 2016, un pipeline Spark lit 60 To de données compressées et redistribue puis trie 90 To de données intermédiaires pour préparer un système de classement. Après optimisation, il termine environ cinq fois plus vite que l’ancien pipeline Hive. Source : Facebook Engineering.
- Criteo : plusieurs dizaines de To par jour. En 2020, Criteo explique utiliser Spark pour traiter les nouvelles données servant à entraîner ses modèles de recommandation publicitaire. Source : Criteo Engineering.
- Salesforce : des pétaoctets de données clients. Dans Data Cloud, Spark transforme et harmonise les données collectées dans le lac de données pour les rendre exploitables par les services de la plateforme. Source : Salesforce Engineering.
- Adobe : des données à l’échelle des pétaoctets. Adobe Experience Platform utilise Spark pour accéder à son lac de données. Les utilisateurs exécutent des milliers de requêtes sur des dizaines de milliers de jeux de données. Source : Adobe.
Définition : Apache Spark
Apache Spark est un moteur de calcul distribué et open source, conçu pour analyser de grands volumes de données. Il découpe le travail en tâches qui peuvent être exécutées en parallèle sur un cluster de plusieurs machines.
Le projet est développé au sein de l’Apache Software Foundation, avec les contributions de plusieurs entreprises, dont Databricks, fondée par les créateurs de Spark. Source : Databricks.
- Rapide : le calcul parallèle et la réutilisation des données en mémoire peuvent réduire le temps de traitement.
- Simple à programmer : des opérations de lecture, de filtrage et d’agrégation accessibles en Python avec PySpark, ainsi qu’en Scala, Java, R et SQL selon les API.
- Polyvalent : traitements batch, streaming, analyses SQL et machine learning.
- Tolérant aux pannes : recalcul des partitions de RDD perdues.
L’écosystème Spark
L’écosystème Spark repose sur un socle commun et des API de plus haut niveau. Le schéma se lit de bas en haut :
Faites défiler le schéma horizontalement sur petit écran.
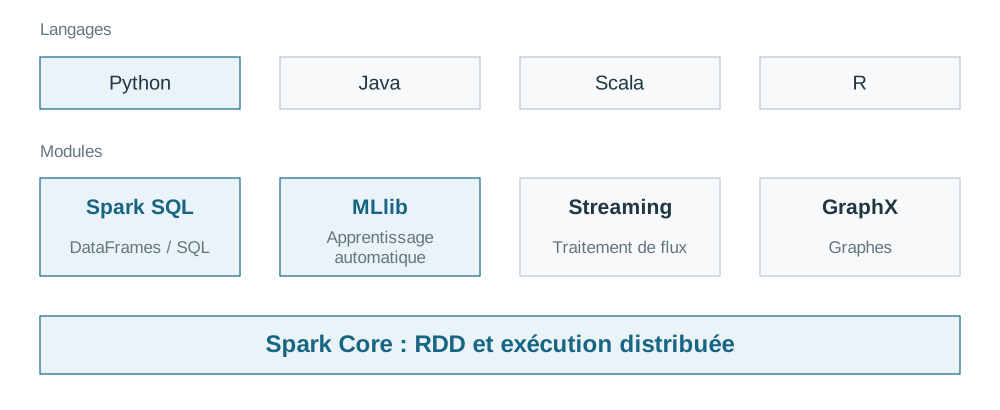
- À la base, Spark Core assure l’exécution distribuée : planification des tâches, traitement des partitions et reprise après une panne. Il fournit les RDD, l’API de bas niveau.
- Au-dessus, Spark SQL et les DataFrames constituent une API de haut niveau pour les données structurées. Les opérations portent sur des colonnes et des tables.
- Les modules spécialisés complètent cet ensemble : Structured Streaming pour les flux, MLlib pour le machine learning et GraphX pour les graphes.
- Les interfaces de langage permettent d’utiliser Spark depuis Python, Scala, Java ou R, selon les API disponibles. Nous utiliserons Python avec PySpark.
Spark propose deux niveaux pour décrire les traitements :
- Bas niveau : les RDD : vous manipulez les éléments d’une collection distribuée et définissez les fonctions à leur appliquer. Cette API convient aux traitements sur mesure, difficiles à exprimer avec des opérations sur des tables.
- Haut niveau : les DataFrames et Spark SQL : vous manipulez des colonnes et des tables. Ces API sont à privilégier pour les traitements de données structurées : filtrer, agréger, joindre ou préparer des données pour l’analyse.
Nous commencerons par les RDD pour comprendre les mécanismes d’exécution, puis nous passerons aux DataFrames et à Spark SQL, une API de plus haut niveau pour les traitements de données structurées.
Architecture d’une application Spark
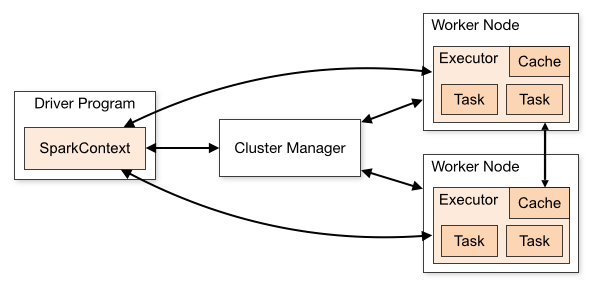
Exécuter un traitement sur plusieurs machines demande de répartir le travail, d’attribuer les ressources et de suivre les calculs. L’architecture de Spark organise cette coordination au sein d’un cluster, un ensemble de machines reliées par un réseau. Elle repose sur les composants suivants :
- Le driver est le processus qui exécute votre programme principal. À partir des opérations décrites dans votre code, il construit un graphe de calcul, appelé DAG (Directed Acyclic Graph, ou graphe orienté sans cycle). Il organise ensuite son exécution en stages et en tâches, transmet les tâches aux executors et suit leur progression. Lorsque l’opération le demande, il récupère les résultats pour les rendre disponibles au programme ou les afficher à l’utilisateur.
- Un worker est une machine du cluster sur laquelle des calculs peuvent être exécutés. Elle apporte des ressources : cœurs de calcul, mémoire et espace disque.
- Un executor est un processus lancé sur un worker pour une application Spark. Il exécute les tâches reçues du driver et peut conserver des données en mémoire ou sur disque. Un executor peut exécuter plusieurs tâches en parallèle, selon les ressources qui lui sont attribuées.
- Le gestionnaire de cluster attribue les ressources aux applications. Kubernetes, Hadoop YARN ou Spark Standalone peuvent remplir ce rôle. Par exemple, lorsqu’une application demande des executors, il organise leur lancement sur les machines disposant des ressources nécessaires.
Faites défiler le schéma horizontalement sur petit écran.
Source : documentation officielle Apache Spark 3.5.7.
Sur le schéma, les executors se trouvent à l’intérieur des workers. Le driver leur envoie les tâches ; le gestionnaire de cluster attribue les ressources.
Le driver prépare le calcul avant de l’exécuter. Avec les RDD, il suit les dépendances entre les opérations. Avec les DataFrames et SQL, Spark construit un plan logique, qui décrit les opérations demandées, puis l’optimise et le transforme en plan physique, qui précise comment les exécuter.
SparkContext et SparkSession : les points d’entrée
Dans le code suivant, sc donne accès à Spark et permet de créer un RDD.
from pyspark import SparkConf, SparkContext

# Créer ou récupérer le point d'entrée vers Spark
conf = SparkConf().setMaster("local[2]").setAppName("CM3-RDD")
sc = SparkContext.getOrCreate(conf)

nombres = sc.parallelize([1, 2, 3], 2)       # Créer un RDD en 2 partitions
doubles = nombres.map(lambda x: x * 2)      # Décrire une transformation
print(doubles.collect()) # Demander le calcul : [2, 4, 6]SparkContext, nommésc, est le point d’entrée pour les RDD. Par exemple,sc.textFile("mots.txt")crée un RDD à partir d’un fichier. Le contexte se trouve du côté du driver et coordonne l’exécution avec les executors.SparkSession, nomméespark, est le point d’entrée pour les DataFrames et Spark SQL. Par exemple,spark.read.csv("ventes.csv", header=True)crée un DataFrame à partir d’un fichier CSV, etspark.sql(...)permet d’écrire une requête SQL.
Étapes d’exécution d’un traitement
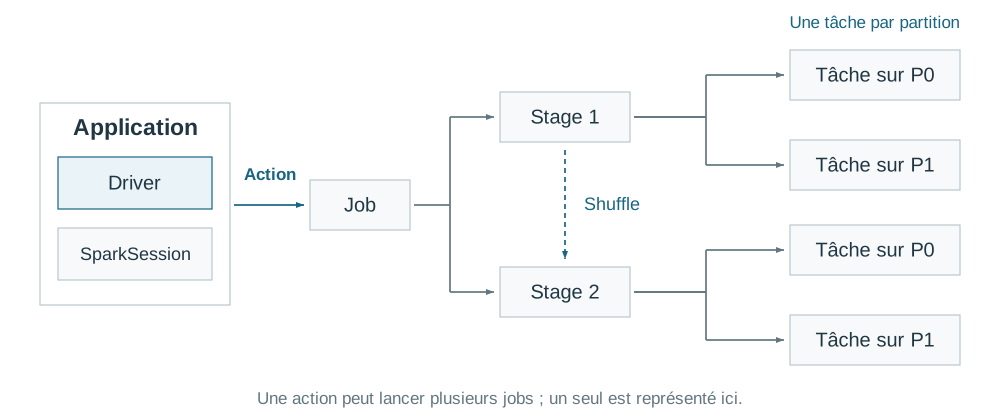
Votre programme s’exécute dans une application Spark, composée d’un driver et de ses executors. Cette application peut lire des données, effectuer plusieurs calculs et produire plusieurs résultats.
Les données sont découpées en partitions ; leur traitement est confié à des tâches.
- Une partition est une partie d’un jeu de données. Elle contient, par exemple, une partie des lignes d’un fichier.
- Une tâche est un travail envoyé à un executor pour traiter une partition à une étape du calcul. Elle peut enchaîner plusieurs opérations, comme filtrer des lignes puis transformer celles qui restent.
Un stage rassemble les tâches d’une même étape. Ces tâches appliquent la même suite d’opérations à des partitions différentes. Elles peuvent s’exécuter en parallèle, selon les ressources disponibles.
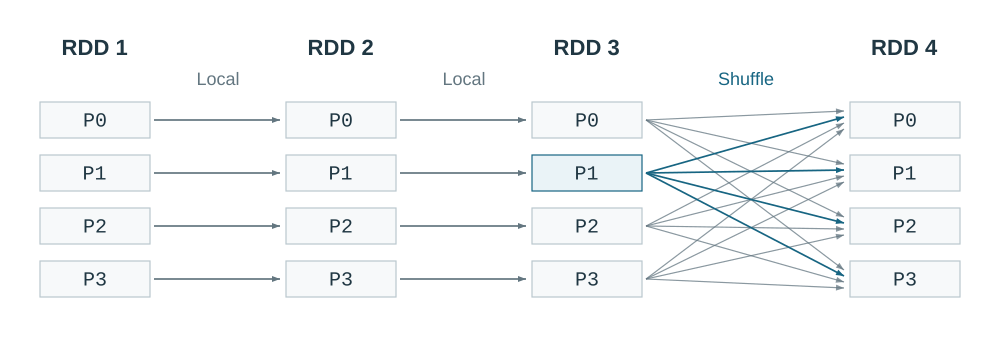
Certaines opérations nécessitent de redistribuer les données entre partitions. Par exemple, pour additionner les ventes par boutique, Spark doit réunir les montants associés à une même boutique. Cet échange, appelé shuffle, crée une frontière entre deux stages : le premier prépare les données à échanger, le suivant utilise les données redistribuées.
Un job regroupe les stages nécessaires pour réaliser un calcul. Il est lancé lorsqu’une action demande un résultat, par exemple compter les éléments avec count() ou les récupérer avec collect(). Une action peut déclencher un ou plusieurs jobs.
Faites défiler le schéma horizontalement sur petit écran.
RDD : Resilient Distributed Dataset
Un RDD, pour Resilient Distributed Dataset, est une collection d’éléments répartie en partitions que Spark peut traiter en parallèle.
- Immuable : une transformation crée un nouveau RDD ; elle ne modifie pas celui de départ.
- Distribué : les partitions peuvent être traitées sur plusieurs machines.
- Résilient : une partition perdue peut être recalculée à partir de ses dépendances.
Par exemple, rdd.filter(lambda x: x > 3) décrit un nouveau RDD filtré. Le RDD nommé rdd conserve les éléments de départ.
Faites défiler le schéma horizontalement sur petit écran.
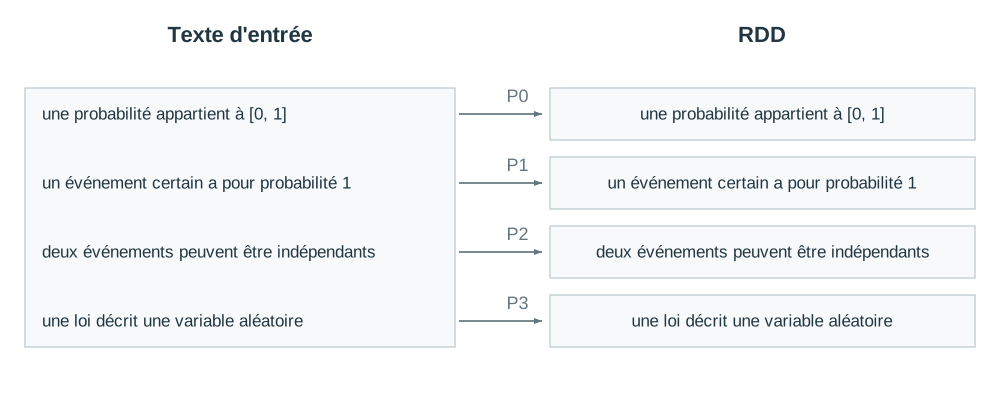
Dans cet exemple illustratif, chaque ligne sur les probabilités est un élément du RDD, placé dans l’une des quatre partitions P0 à P3. Une partition peut contenir plusieurs éléments. Une partition n’est pas une machine : une même machine peut traiter plusieurs partitions.
Créer un RDD
Deux façons de créer un RDD :
- Une collection Python, pour un petit exemple déjà présent dans le driver.
- Une source externe, par exemple un fichier texte que Spark lira pendant le calcul.
Les exemples réutilisent le même contexte sc. Dans un notebook où PySpark est installé, local[2] démarre Spark en mode local avec deux threads de calcul :
from pyspark import SparkConf, SparkContext

conf = SparkConf().setMaster("local[2]").setAppName("CM3-RDD")
sc = SparkContext.getOrCreate(conf)
Avec parallelize, le second argument fixe ici le nombre de partitions :
nombres = sc.parallelize([1, 2, 3, 4], 2)
print(nombres.getNumPartitions())  # 2
DAG et lineage
Spark représente les dépendances entre les calculs sous forme d’un DAG (Directed Acyclic Graph), ou graphe orienté acyclique. Ce graphe indique quels résultats sont nécessaires à chaque étape et dans quel ordre les calculs peuvent être exécutés.
- Orienté : les flèches vont des RDD parents aux RDD qui en dépendent.
- Acyclique : aucun chemin ne revient à son point de départ.
On suppose les RDD de paires rdd1, rdd3 et rdd5 déjà créés. Les opérations suivantes définissent leurs dépendances. Le driver en construit le graphe de calcul, puis prépare les stages et les tâches lorsqu’une action demande le résultat.
# Décrire les dépendances du graphe
rdd2 = rdd1.groupByKey(numPartitions=3)
rdd4 = rdd3.mapValues(lambda x: x * 2)
rdd6 = rdd4.union(rdd5)
rdd7 = rdd2.join(rdd6, numPartitions=3)

# Demander l'exécution
resultat = rdd7.collect()
Le schéma reprend ces dépendances. Le placement des éléments dans les partitions est illustratif.
Faites défiler le schéma horizontalement sur petit écran.
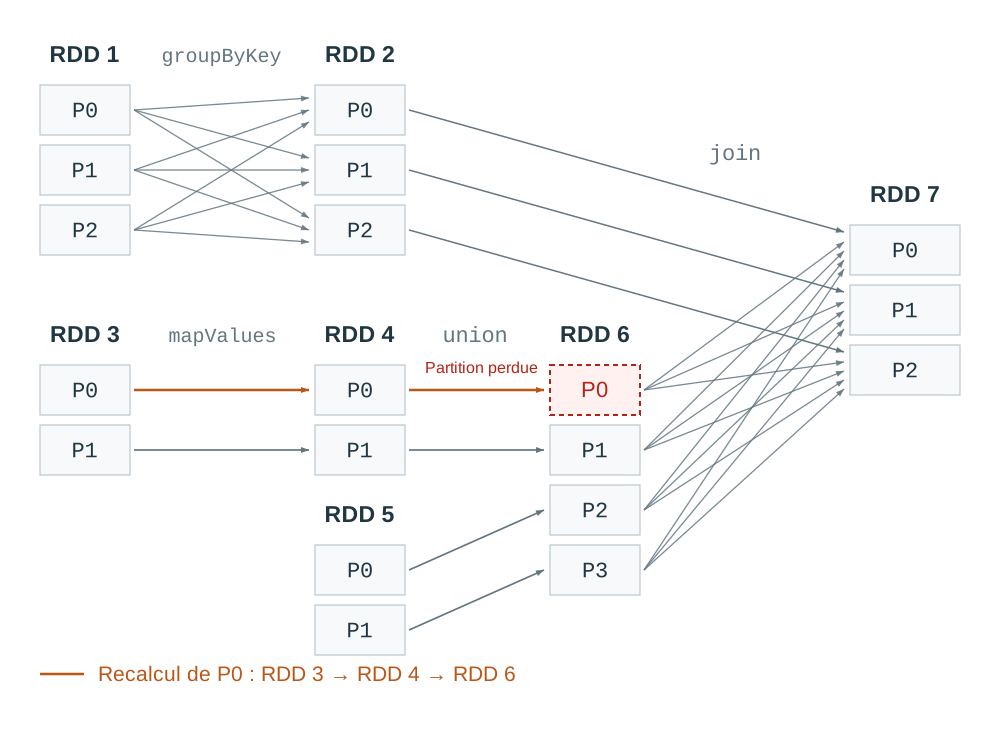
Supposons qu’une machine tombe en panne et que la partition P0 du RDD 6, conservée sur cette machine, soit perdue. Spark n’a pas besoin de recalculer tout le RDD : il utilise le lineage, c’est-à-dire les dépendances enregistrées entre les RDD, pour retrouver les opérations nécessaires à sa reconstruction.
Le chemin orange suit le recalcul : Spark repart de P0 du RDD 3, recalcule P0 du RDD 4, puis reconstruit P0 du RDD 6. Une partition intermédiaire encore disponible peut être réutilisée.
Cette reconstruction suppose des sources accessibles et des opérations reproductibles.
Transformations : décrire le calcul
Une transformation prend un ou plusieurs RDD en entrée et renvoie un nouveau RDD. Elle décrit une opération dont l’exécution sera demandée par une action : c’est l’évaluation paresseuse, ou lazy evaluation.
Faites défiler le schéma horizontalement sur petit écran.
map
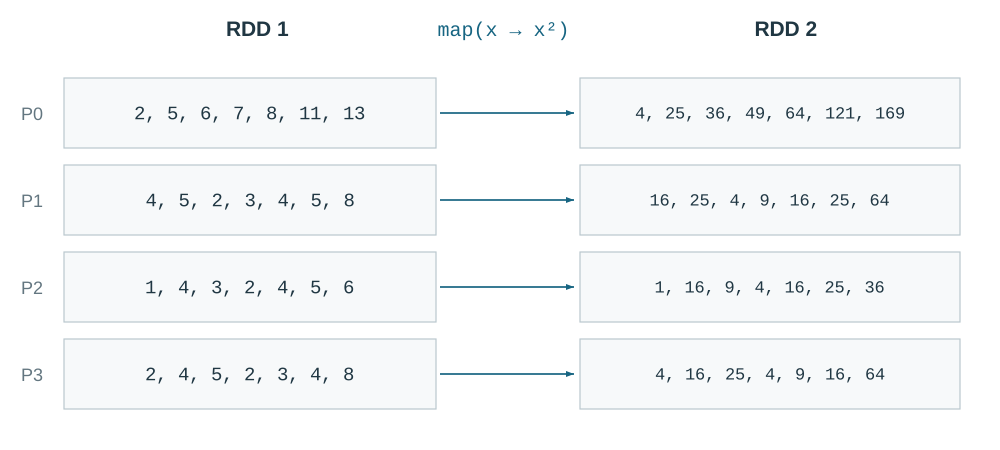
map(f) produit un élément de sortie pour chaque élément d’entrée.
Ici, map remplace chaque nombre par son carré : 5 devient 25, dans la même partition.
Faites défiler le schéma horizontalement sur petit écran.
map.
filter
filter(predicat) conserve les éléments qui satisfont une condition. Le prédicat est une fonction qui renvoie vrai ou faux.
Dans la figure, x > 3 retire les valeurs 1, 2 et 3. Les éléments conservés restent dans leur partition d’origine ; une partition peut devenir vide.
Faites défiler le schéma horizontalement sur petit écran.
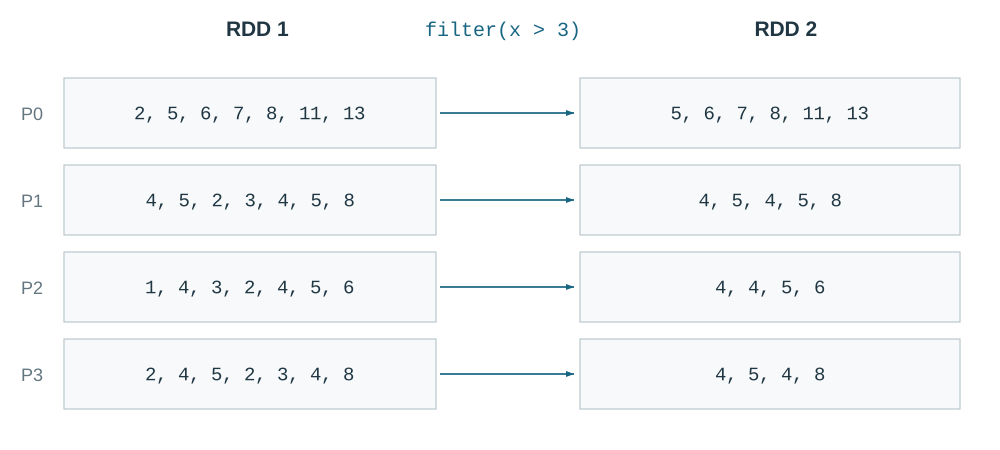
filter.
distinct
distinct() retire les doublons. Les occurrences d’une même valeur peuvent se trouver dans plusieurs partitions ; Spark doit alors les rapprocher par un shuffle.
Faites défiler le schéma horizontalement sur petit écran.
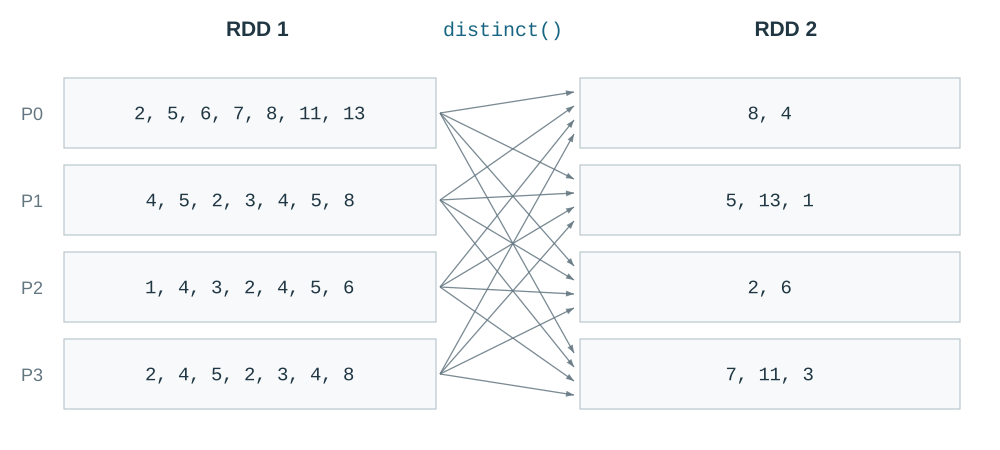
distinct et redistribution.
Les flèches montrent les contributions entre partitions. Les occurrences d’une même valeur sont regroupées pour n’en conserver qu’une. Le placement des valeurs est illustratif ; l’ordre du résultat n’est pas garanti.
Dépendances étroites et larges
Une dépendance indique quelles partitions d’entrée sont nécessaires pour calculer une partition de sortie. Spark distingue deux cas selon qu’une redistribution des données est nécessaire ou non.
| Dépendance | Définition | Exemples |
|---|---|---|
| Étroite, narrow | Pour calculer une partition de sortie, Spark utilise une ou quelques partitions d’entrée identifiées, sans redistribuer les données par un shuffle. | map, filter, flatMap, union |
| Large, wide | Pour calculer les partitions de sortie, Spark doit redistribuer les données provenant des partitions d’entrée. Cet échange est appelé shuffle. | distinct, intersection |
Sources : documentation Spark 3.5.7 sur les dépendances étroites et les shuffles.
Actions : demander un résultat
Une action demande à Spark d’exécuter le calcul nécessaire et de produire un résultat ou un effet, comme une écriture. Le choix dépend de ce que le programme doit récupérer.
reduce: une valeur agrégée.collect: tous les éléments vers le driver.count: le nombre d’éléments.
reduce : une valeur agrégée
reduce(f) combine les éléments du RDD en une seule valeur. La fonction doit être associative et commutative pour que les combinaisons parallèles donnent un résultat correct.
La figure additionne d’abord les valeurs dans chaque partition, puis combine les sommes partielles : 7 + 6 + 6 + 11 = 30 au driver.
Faites défiler le schéma horizontalement sur petit écran.
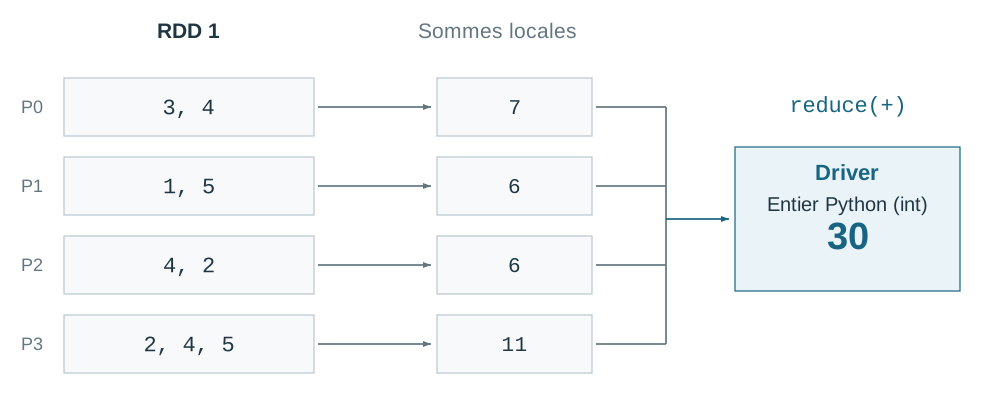
reduce sur quatre partitions.
collect : tous les éléments vers le driver
collect() renvoie tous les éléments dans la mémoire du driver. Dans la figure, les quatre partitions produisent une liste de neuf valeurs.
Faites défiler le schéma horizontalement sur petit écran.
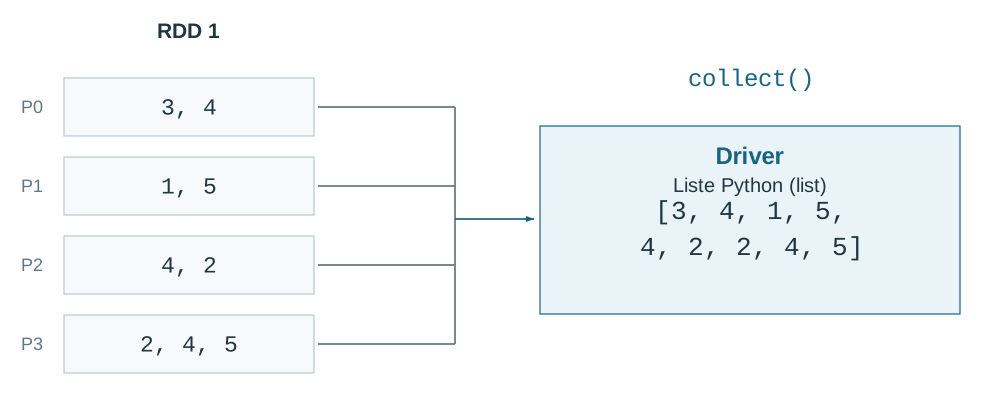
collect.
collect() peut saturer le driver sur un RDD volumineux. Filtrez, agrégez ou limitez le résultat avant de le rapatrier. Pour une prévisualisation, take(n) renvoie au plus n éléments.
count : un nombre d’éléments
count() renvoie le nombre total d’éléments. Sur les mêmes partitions, les comptes partiels donnent 2 + 2 + 2 + 3 = 9. Seul ce nombre revient au driver.
Faites défiler le schéma horizontalement sur petit écran.
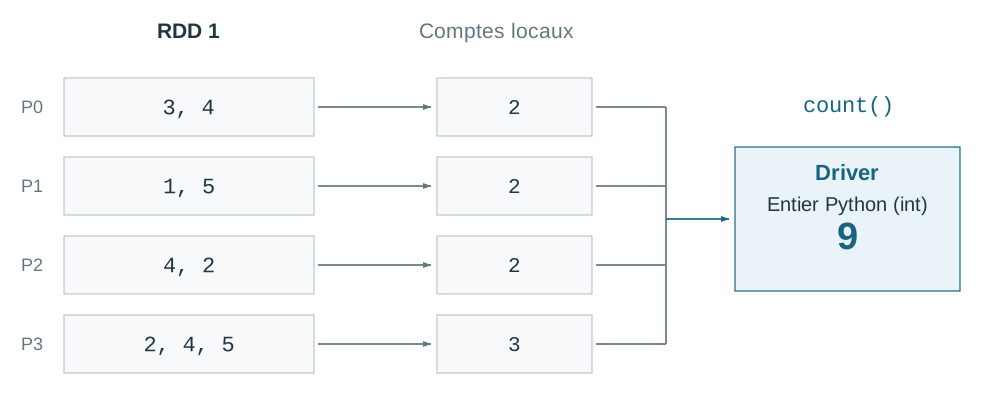
count.
RDD clé-valeur
Un RDD clé-valeur contient des couples (clé, valeur). Par exemple, dans ("spark", 1), la clé est le mot "spark" et la valeur indique une occurrence.
Ce format permet de traiter ensemble les valeurs associées à une même clé :
reduceByKeycombine ces valeurs, par exemple pour calculer une somme.groupByKeyrassemble ces valeurs sans les agréger.mapValuestransforme les valeurs en conservant les clés.
La figure part de comptes par mot déjà calculés dans chaque partition. reduceByKey additionne les valeurs d’une même clé : pour cat, 2 + 2 + 3 = 7.
Faites défiler le schéma horizontalement sur petit écran.
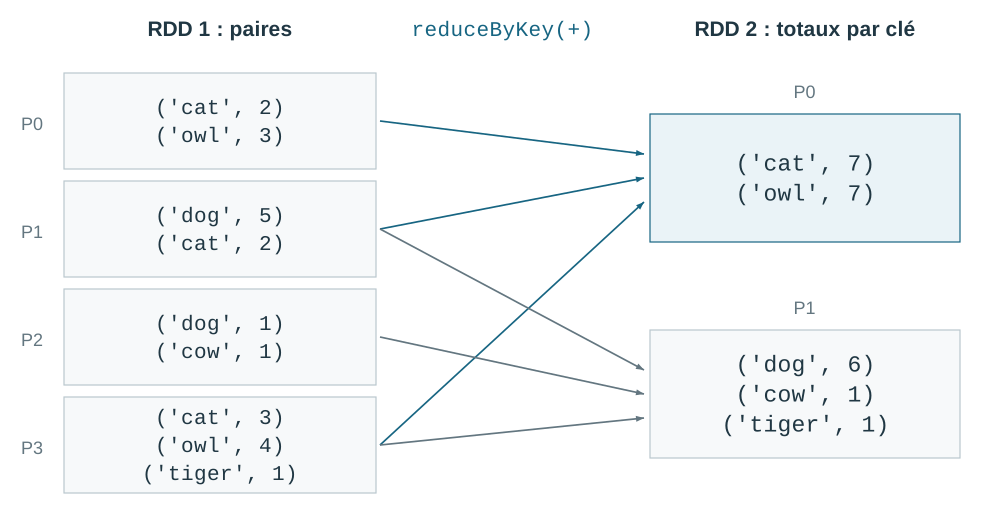
reduceByKey.
Exemple complet : compter les M&M’s par couleur
Un sachet contient six M&M’s. Combien y en a-t-il de chaque couleur ? Chaque élément du RDD représente la couleur d’un bonbon.
couleurs = ["rouge", "bleu", "jaune", "rouge", "bleu", "rouge"]

rdd1 = sc.parallelize(couleurs, 2)                  # Deux partitions
rdd2 = rdd1.map(lambda couleur: (couleur, 1))       # Un couple par bonbon
rdd3 = rdd2.reduceByKey(lambda a, b: a + b, 2)      # Additionner par couleur
resultat = rdd3.collect()                          # Liste Python sur le driver

print(sorted(resultat))
[('bleu', 2), ('jaune', 1), ('rouge', 3)]map associe 1 à chaque couleur, reduceByKey additionne ces valeurs et collect déclenche le calcul pour récupérer le résultat.
Tableau des transformations
Toutes ces transformations renvoient un nouveau RDD.
| Transformation | Fonction dans ce cours |
|---|---|
map(func) |
Applique une fonction à chaque élément ; produit un nouvel élément par entrée. |
flatMap(func) |
Produit zéro, un ou plusieurs éléments par entrée, puis les aplatit dans le RDD de sortie. |
filter(func) |
Garde les éléments qui satisfont le prédicat. |
reduceByKey(func) |
Agrège les valeurs de chaque clé avec une fonction associative et commutative ; la combinaison locale peut réduire les données échangées. |
groupByKey() |
Rassemble les valeurs associées à chaque clé ; moins adapté qu’une réduction par clé si seule une somme ou une moyenne est attendue. |
sortByKey() |
Trie les paires clé-valeur selon la clé. |
join(otherRDD) |
Associe les paires de deux RDD qui partagent une clé ; plusieurs valeurs par clé peuvent multiplier les lignes. |
union(otherRDD) |
Concatène les éléments des deux RDD, sans déduplication. |
intersection(otherRDD) |
Conserve les valeurs communes aux deux RDD. |
distinct() |
Supprime les doublons. |
sample(withReplacement, fraction) |
Échantillonne une fraction, avec ou sans remise ; une graine optionnelle facilite la répétition de l’exemple. |
mapValues(func) |
Applique la fonction aux valeurs d’un RDD de paires sans modifier les clés. |
coalesce(numPartitions) |
Réduit le nombre de partitions ; un shuffle peut être demandé explicitement selon l’API. |
repartition(numPartitions) |
Modifie le nombre de partitions avec une redistribution complète. |
cartesian(otherRDD) |
Forme les couples du produit cartésien ; la taille de sortie peut croître très vite. |
Tableau des actions
Une action produit une valeur au driver ou un effet, comme une écriture. Repérez la quantité de données retournée et la destination du résultat.
| Action | Résultat ou effet |
|---|---|
collect() |
Renvoie tous les éléments au driver ; à réserver aux résultats qui tiennent dans sa mémoire. |
count() |
Renvoie le nombre total d’éléments. |
take(n) |
Renvoie au driver au plus n éléments pour en consulter un aperçu. |
reduce(func) |
Combine les éléments en une valeur avec une fonction associative et commutative. |
first() |
Renvoie un premier élément du RDD. |
countByKey() |
Compte les occurrences de chaque clé d’un RDD de paires et renvoie la table au driver ; attention au nombre de clés. |
saveAsTextFile(path) |
Écrit les partitions sous forme de fichiers texte dans le dossier cible. |
saveAsSequenceFile(path) |
Écrit des paires clé-valeur au format SequenceFile dans un environnement Hadoop compatible. |
foreach(func) |
Exécute une fonction sur les éléments côté tâches ; modifier une variable ordinaire du driver dans cette fonction n’est pas un mécanisme de retour fiable. |
À retenir
- Spark répartit les données et le calcul entre plusieurs machines pour traiter de grands volumes.
- Un RDD est une collection immuable, découpée en partitions. Chaque transformation décrit un nouveau RDD.
- Les transformations décrivent le traitement ; une action déclenche le calcul nécessaire au résultat demandé.
- Le driver organise le travail et les executors exécutent les tâches sur les partitions. Un shuffle redistribue les données entre partitions et sépare les stages.
- Le lineage mémorise les dépendances permettant de recalculer une partition perdue, si les sources restent accessibles et les opérations reproductibles.
Comment Spark répartit ce calcul
Faites défiler le schéma horizontalement sur petit écran.
collect.